2020/2/10

如何在 Markdown 輸入數學公式及符號

使用 latex 語法在 Markdown 輸入數學公式及符號


數學公式


1. 如何插入公式


有行內公式與獨立公式兩種


$ 行內公式 $


$$ 獨立公式 $$


ex:


行內公式 \(F=ma\)


獨立公式 \[F=ma\]


2. 上下標


上標符號,符號 ^, ex: $x^2$,就是 \(x^2\)


下標符號,符號:_,ex: $x_2$,就是 \( x_2 \)


組合符號,符號:{},ex: $x_{12}$,就是 \(x_{12}\)


如果要在左右兩邊都有上下標,可以用 \sideset 命令。


$$ \sideset{^1_2}{^3_4}\bigotimes $$

\[ \sideset{^1_2}{^3_4}\bigotimes \]


3. 括號


()、[] 和 | 表示符號本身,用 \{\} 來表示 {} 。當要顯示大號的括號或分隔符時,要用 \left 和 \right 命令。


一些特殊的括號:


輸入 顯示 輸入 顯示
\langle \(\langle\) \rangle \(\rangle\)
\lceil \(\lceil\) \rceil \(\rceil\)
\lfloor \(\lfloor\) \rfloor \(\rfloor\)
\lbrace \(\lbrace\) \rbrace \(\rbrace\)

ex1:


$$ f(x,y,z) = 3y^2z \left( 3+\frac{7x+5}{1+y^2} \right) $$

\[ f(x,y,z) = 3y^2z \left( 3+\frac{7x+5}{1+y^2} \right) \]


ex2:


$$ \left. \frac{{\rm d}u}{{\rm d}x} \right| _{x=0} $$

\[ \left. \frac{{\rm d}u}{{\rm d}x} \right| _{x=0} \]


4. 分數


通常用 \frac {分子} {分母} 產生一個分數,分數可嵌套。
可直接輸入 \frac ab 來快速生成一個 \(\frac ab\) 。
如果分式很複雜,亦可使用 分子 \over 分母 命令,此時分數僅有一層。


ex:


$$\frac{a-1}{b-1} \quad and \quad {a+1\over b+1}$$

\[\frac{a-1}{b-1} \quad and \quad {a+1\over b+1}\]


5. 開方


\sqrt [根指數,省略時為2] {被開方數} 輸入開方。


ex:


$$\sqrt{2} \quad and \quad \sqrt[n]{3}$$

\[\sqrt{2} \quad and \quad \sqrt[n]{3}\]


6. 省略符號


數學公式中常見的省略號有兩種,\ldots 表示與文本底線對齊的省略號,\cdots 表示與文本中線對齊的省略號。


ex:


$$ f(x_1,x_2,\underbrace{\ldots}_{\rm ldots} ,x_n) = x_1^2 + x_2^2 + \underbrace{\cdots}_{\rm cdots} + x_n^2 $$

\[f(x_1,x_2,\underbrace{\ldots}_{\rm ldots} ,x_n) = x_1^2 + x_2^2 + \underbrace{\cdots}_{\rm cdots} + x_n^2\]


7. 向量


\vec{向量} 產生一個向量。也可以用 \overrightarrow 自訂字母上方的符號。


ex:


$$\vec{a} \cdot \vec{b}=0$$

\[\vec{a} \cdot \vec{b}=0\]


ex:


$$\overleftarrow{xy} \quad and \quad \overleftrightarrow{xy} \quad and \quad \overrightarrow{xy}$$

\[\overleftarrow{xy} \quad and \quad \overleftrightarrow{xy} \quad and \quad \overrightarrow{xy}\]


8. 微積分


\int_積分下限^積分上限 {積分表達式}


ex:


$$\int_0^1 {x^2} \,{\rm d}x $$

\[\int_0^1 {x^2} \,{\rm d}x\]


本例中 \, 和 {\rm d} 部分可省略,但建議加入,能使式子更美觀。


\[\int_0^1 {x^2} dx \] 可發現 d 的部分跟上面有一點不一樣


\partial{}微分


ex:


\frac{\partial x}{\partial y}   

\(\frac{\partial x}{\partial y}\)


9. 極限


\lim_{變數 \to 表達式} 表達式


如有需要,可以修改 \to 符號為任意符號。


ex:


$$ \lim_{n \to +\infty} \frac{1}{n(n+1)} \quad and \quad \lim_{x\leftarrow{sample}} \frac{1}{n(n+1)} $$

\[ \lim_{n \to +\infty} \frac{1}{n(n+1)} \quad and \quad \lim_{x\leftarrow{sample}} \frac{1}{n(n+1)} \]


10. 級數


\sum_{下標表達式}^{上標表達式} {級數表達式}
與之類似,使用 \prod \bigcup \bigcap 來分別輸入連乘、聯集和交集


ex:


$$\sum_{i=1}^n \frac{1}{i^2} \quad and \quad \prod_{i=1}^n \frac{1}{i^2} \quad and \quad \bigcup_{i=1}^{2} R$$

\[\sum_{i=1}^n \frac{1}{i^2} \quad and \quad \prod_{i=1}^n \frac{1}{i^2} \quad and \quad \bigcup_{i=1}^{2} R\]


11. 希臘字母


\小寫希臘字母英文全稱 和 \首字母大寫希臘字母英文全稱 來分別輸入小寫和大寫希臘字母。對於大寫希臘字母與現有字母相同的,直接輸入大寫字母即可。也可以直接用該字母,簡化數學式的寫法。


輸入 顯示 輸入 顯示 輸入 顯示 輸入 顯示
\alpha \(\alpha\) A \(A\) \beta \(\beta\) B \(B\)
\gamma \(\gamma\) \Gamma \(\Gamma\) \delta \(\delta\) \Delta \(\Delta\)
\epsilon \(\epsilon\) E \(E\) \zeta \(\zeta\) Z \(Z\)
\eta \(\eta\) H \(H\) \theta \(\theta\) \Theta \(\Theta\)
\iota \(\iota\) I \(I\) \kappa \(\kappa\) K \(K\)
\lambda \(\lambda\) \Lambda \(\Lambda\) \mu \(\mu\) M \(M\)
\nu \(\nu\) N \(N\) \xi \(\xi\) \Xi \(\Xi\)
o \(o\) O \(O\) \pi \(\pi\) \Pi \(\Pi\)
\rho \(\rho\) P \(P\) \sigma \(\sigma\) \Sigma \(\Sigma\)
\tau \(\tau\) T \(T\) \upsilon \(\upsilon\) \Upsilon \(\Upsilon\)
\phi \(\phi\) \Phi \(\Phi\) \chi \(\chi\) X \(X\)
\psi \(\psi\) \Psi \(\Psi\) \omega \(\omega\) \Omega \(\Omega\)

部分字母有變數專用形式,以 \var- 開頭。


小寫形式 大寫形式 變量形式 顯示
\epsilon E \varepsilon \(\epsilon \mid E \mid \varepsilon\)
\theta \Theta \vartheta \(\theta \mid \Theta \mid \vartheta\)
\rho P \varrho \(\rho \mid P \mid \varrho\)
\sigma \Sigma \varsigma \(\sigma \mid \Sigma \mid \varsigma\)
\phi \Phi \varphi \(\phi \mid \Phi \mid \varphi\)

12. 特殊符號


可在 Detexify 畫出符號,找到該符號的 latex 語法


若需要顯示更大或更小的字元,在符號前插入 \large 或 \small


12.1 關係運算


輸入 顯示 輸入 顯示 輸入 顯示 輸入 顯示
\pm \(\pm\) \times \(\times\) \div \(\div\) \mid \(\mid\)
\nmid \(\nmid\) \cdot \(\nmid\) \circ \(\nmid\) \ast \(\ast\)
\bigodot \(\ast\) \bigotimes \(\ast\) \bigoplus \(\bigoplus\) \leq \(\bigoplus\)
\geq \(\geq\) \neq \(\neq\) \approx \(\approx\) \equiv \(\equiv\)
\sum \(\sum\) \prod \(\sum\) \coprod \(\coprod\) \backslash \(\backslash\)
\ngeq \(\ngeq\) \nleq \(\nleq\) \not\geq \(\not\geq\) \not\leq \(\not\leq\)

12.2 集合運算


輸入 顯示 輸入 顯示 輸入 顯示
\emptyset \(\emptyset\) \in \(\in\) \notin \(\notin\)
\subset \(\subset\) \supset \(\supset\) \subseteq \(\subseteq\)
\supseteq \(\supseteq\) \bigcap \(\bigcap\) \bigcup \(\bigcup\)
\bigvee \(\bigvee\) \bigwedge \(\bigwedge\) \biguplus \(\biguplus\)
\subsetneq \(\subsetneq\) \supsetneq \(\supsetneq\) \setminus \(\setminus\)
\bigodot \(\bigodot\) \bigotimes \(\bigotimes\) \mathbb{R} \(\mathbb{R}\)
\mathbb{Z} \(\mathbb{Z}\)

12.3 對數


輸入 顯示 輸入 顯示 輸入 顯示
\log \(\log\) \lg \(\lg\) \ln \(\ln\)

12.4 三角函數


輸入 顯示 輸入 顯示 輸入 顯示
30^\circ \(30^\circ\) \bot \(\bot\) \angle A \(\angle A\)
\sin \(\sin\) \cos \(\cos\) \tan \(\tan\)
\csc \(\csc\) \sec \(\sec\) \cot \(\cot\)

12.5 微積分


輸入 顯示 輸入 顯示 輸入 顯示
\int \(\int\) \iint \(\iint\) \iiint \(\iiint\)
\iiiint \(\iiiint\) \oint \(\oint\) \prime \(\prime\)
\lim \(\lim\) \infty \(\infty\) \nabla \(\nabla\)

12.6 邏輯運算


輸入 顯示 輸入 顯示 輸入 顯示
\because \(\because\) \therefore \(\therefore\)
\forall \(\forall\) \exists \(\exists\) \not\subset \(\not\subset\)
\not< \(\not<\) \not> \(\not>\) \not= \(\not=\)

12.7 hat


輸入 顯示 輸入 顯示
\hat{xy} \(\hat{xy}\) \widehat{xyz} \(\widehat{xyz}\)
\tilde{xy} \(\tilde{xy}\) \widetilde{xyz} \(\widetilde{xyz}\)
\check{x} \(\check{x}\) \breve{y} \(\breve{y}\)
\grave{x} \(\grave{x}\) \acute{y} \(\acute{y}\)

12.8 連線


輸入 顯示
\fbox{a+b+c+d} \(\fbox{a+b+c+d}\)
\overleftarrow{a+b+c+d} \(\overleftarrow{a+b+c+d}\)
\overrightarrow{a+b+c+d} \(\overrightarrow{a+b+c+d}\)
\overleftrightarrow{a+b+c+d} \(\overleftrightarrow{a+b+c+d}\)
\underleftarrow{a+b+c+d} \(\underleftarrow{a+b+c+d}\)
\underrightarrow{a+b+c+d} \(\underrightarrow{a+b+c+d}\)
\underleftrightarrow{a+b+c+d} \(\underleftrightarrow{a+b+c+d}\)
\overline{a+b+c+d} \(\overline{a+b+c+d}\)
\underline{a+b+c+d} \(\underline{a+b+c+d}\)
\overbrace{a+b+c+d}^{Sample} \(\overbrace{a+b+c+d}^{Sample}\)
\underbrace{a+b+c+d}_{Sample} \(\underbrace{a+b+c+d}_{Sample}\)
\overbrace{a+\underbrace{b+c}_{1.0}+d}^{2.0} \(\overbrace{a+\underbrace{b+c}_{1.0}+d}^{2.0}\)
\underbrace{a\cdot a\cdots a}_{b\text{ times}} \(\underbrace{a\cdot a\cdots a}_{b\text{ times}}\)

12.9 箭頭


輸入 顯示 輸入 顯示 輸入 顯示
\to \(\to\) \mapsto \(\mapsto\)
\implies \(\implies\) \iff \(\iff\) \impliedby \(\impliedby\)

  • 其它可用符號:

輸入 顯示 輸入 顯示
\uparrow \(\uparrow\) \Uparrow \(\Uparrow\)
\downarrow \(\downarrow\) \Downarrow \(\Downarrow\)
\leftarrow \(\leftarrow\) \Leftarrow \(\Leftarrow\)
\rightarrow \(\rightarrow\) \Rightarrow \(\Rightarrow\)
\leftrightarrow \(\leftrightarrow\) \Leftrightarrow \(\Leftrightarrow\)
\longleftarrow \(\longleftarrow\) \Longleftarrow \(\Longleftarrow\)
\longrightarrow \(\longrightarrow\) \Longrightarrow \(\Longrightarrow\)
\longleftrightarrow \(\longleftrightarrow\) \Longleftrightarrow \(\Longleftrightarrow\)

12.10 四則運算


運算 寫法 顯示
加法 x+y \(x+y\)
減法 x-y \(x-y\)
加減 x \pm y \(x \pm y\)
減加 x \mp y \(x \mp y\)
乘法 x \times y \(x \times y\)
星乘法 x \ast y \(x \ast y\)
點乘法 x \cdot y \(x \cdot y\)
除法 x \div y \(x \div y\)
斜除法 x / y \(x / y\)
分數 \frac{x}{y} \(\frac{x}{y}\)
分數 {x}\over{y} \({x}\over{y}\)

12.11 其他


運算 寫法 顯示
無窮 \infty \(\infty\)
虛數 \imath \(\imath\)
虛數 \jmath \(\jmath\)
度 ^{\circ} \(^{\circ}\)

13. 字體轉換


要對公式的某一部分字元進行字體轉換,可以用 {\字體 {需轉換的部分字元}} 命令,其中 \字體 部分可以參照下表選擇合適的字體。一般情況下,預設為意大利體 \(italic\) 。


全部大寫 的字體僅大寫可用。


輸入 說明 顯示 輸入 說明 顯示
\rm 羅馬體 \(\rm{Sample}\) \cal 花體 \(\cal{SAMPLE}\)
\it 意大利體 \(\it{Sample}\) \Bbb 黑板粗體 \(\Bbb{SAMPLE}\)
\bf 粗體 \(\bf{Sample}\) \mit 數學斜體 \(\mit{SAMPLE}\)
\sf 等線體 \(\sf{Sample}\) \scr 手寫體 \(\scr{SAMPLE}\)
\tt 打字機體 \(\tt{Sample}\)
\frak 舊德式字體 \(\frak{Sample}\)

轉換字體十分常用,例如在積分中:


\begin{array}{cc}
\mathrm{Bad} & \mathrm{Better} \\
\hline \\
\int_0^1 x^2 dx & \int_0^1 x^2 \,{\rm d}x
\end{array}

\(\begin{array}{cc}
\mathrm{Bad} & \mathrm{Better} \\
\hline \\
\int_0^1 x^2 dx & \int_0^1 x^2 \,{\rm d}x
\end{array}\)


14. 大括號與行標


\left 和 \right 來產生自動匹配高度的 (圓括號),[方括號] 和 {大括號}。
在每個公式結束前用 \tag{行標} 來實現行標。


$$
f\left(
   \left[
     \frac{
       1+\left\{x,y\right\}
     }{
       \left(
          \frac{x}{y}+\frac{y}{x}
       \right)
       \left(u+1\right)
     }+a
   \right]^{3/2}
\right)
\tag{行標}
$$

\[
f\left(
\left[
\frac{
1+\left\{x,y\right\}
}{
\left(
\frac{x}{y}+\frac{y}{x}
\right)
\left(u+1\right)
}+a
\right]^{3/2}
\right)
\tag{行標}
\]


如果你需要在不同的行顯示對應括號,可以在每一行對應處使用 \left. 或 \right. 來放一個"影子"括號:


ex:


$$
\begin{aligned}
a=&\left(1+2+3+  \cdots \right. \\
& \cdots+ \left. \infty-2+\infty-1+\infty\right)
\end{aligned}
$$

\[
\begin{aligned}
a=&\left(1+2+3+ \cdots \right. \\
& \cdots+ \left. \infty-2+\infty-1+\infty\right)
\end{aligned}
\]


要將行內顯示的分隔符也變大,可以使用 \middle


$$
\left\langle
  q
\middle\|
  \frac{\frac{x}{y}}{\frac{u}{v}}
\middle|
   p
\right\rangle
$$

\[
\left\langle
q
\middle\|
\frac{\frac{x}{y}}{\frac{u}{v}}
\middle|
p
\right\rangle
\]


15. 其他指令


15.1 定義新的符號 \operatorname


可查詢 關於此命令的定義 和 關於此命令的討論


ex:


$$ \operatorname{Symbol} A $$

\[\operatorname{Symbol} A\]


15.2 註釋文字 \text


在 \text {文字} 中仍可以使用 $公式$ 插入其它公式。


ex:


$$ f(n)= \begin{cases} n/2, & \text {if $n$ is even} \\ 3n+1, & \text{if $n$ is odd} \end{cases} $$

\[ f(n)= \begin{cases} n/2, & \text {if $n$ is even} \\ 3n+1, & \text{if $n$ is odd} \end{cases} \]


15.3 在字元間加入空格


有四種寬度的空格可以使用: \,、\;、\quad 和 \qquad 。


ex:


$$ a \, b \mid a \; b \mid a \quad b \mid a \qquad b $$

\[ a \, b \mid a \; b \mid a \quad b \mid a \qquad b \]


用 \text {n個空格} 也可以達到同樣效果。


15.4 修改文字顏色


使用 \color{顏色}{文字} 來更改特定的文字顏色。
更改文字顏色 需要瀏覽器支援 ,如果瀏覽器不知道你所需的顏色,那麼文字將為黑色。


對於較舊的瀏覽器(HTML4與CSS2),支援以下顏色:


輸入 顯示 輸入 顯示
black \(\color{black}{text}\) grey \(\color{grey}{text}\)
silver \(\color{silver}{text}\) white \(\color{white}{text}\)
maroon \(\color{maroon}{text}\) red \(\color{red}{text}\)
yellow \(\color{yellow}{text}\) lime \(\color{lime}{text}\)
olive \(\color{olive}{text}\) green \(\color{green}{text}\)
teal \(\color{teal}{text}\) auqa \(\color{auqa}{text}\)
blue \(\color{blue}{text}\) navy \(\color{navy}{text}\)
purple \(\color{purple}{text}\) fuchsia \(\color{fuchsia}{text}\)

對於較新的瀏覽器(HTML5與CSS3),支援額外的124種顏色:


輸入 \color {#rgb} {text} 來自定義更多的顏色,其中 #rgb 的 r g b 可輸入 0-9 和 a-f 來表示紅色、綠色和藍色的純度(飽和度)。


ex:


\begin{array}{|rrrrrrrr|}\hline
\verb+#000+ & \color{#000}{text} & & &
\verb+#00F+ & \color{#00F}{text} & & \\
& & \verb+#0F0+ & \color{#0F0}{text} &
& & \verb+#0FF+ & \color{#0FF}{text}\\
\verb+#F00+ & \color{#F00}{text} & & &
\verb+#F0F+ & \color{#F0F}{text} & & \\
& & \verb+#FF0+ & \color{#FF0}{text} &
& & \verb+#FFF+ & \color{#FFF}{text}\\
\hline
\end{array}

\(\begin{array}{|rrrrrrrr|}\hline
\verb+#000+ & \color{#000}{text} & & &
\verb+#00F+ & \color{#00F}{text} & & \\
& & \verb+#0F0+ & \color{#0F0}{text} &
& & \verb+#0FF+ & \color{#0FF}{text}\\
\verb+#F00+ & \color{#F00}{text} & & &
\verb+#F0F+ & \color{#F0F}{text} & & \\
& & \verb+#FF0+ & \color{#FF0}{text} &
& & \verb+#FFF+ & \color{#FFF}{text}\\
\hline
\end{array}\)


ex:


\begin{array}{|rrrrrrrr|}
\hline
\verb+#000+ & \color{#000}{text} & \verb+#005+ & \color{#005}{text} & \verb+#00A+ & \color{#00A}{text} & \verb+#00F+ & \color{#00F}{text}  \\
\verb+#500+ & \color{#500}{text} & \verb+#505+ & \color{#505}{text} & \verb+#50A+ & \color{#50A}{text} & \verb+#50F+ & \color{#50F}{text}  \\
\verb+#A00+ & \color{#A00}{text} & \verb+#A05+ & \color{#A05}{text} & \verb+#A0A+ & \color{#A0A}{text} & \verb+#A0F+ & \color{#A0F}{text}  \\
\verb+#F00+ & \color{#F00}{text} & \verb+#F05+ & \color{#F05}{text} & \verb+#F0A+ & \color{#F0A}{text} & \verb+#F0F+ & \color{#F0F}{text}  \\
\hline
\verb+#080+ & \color{#080}{text} & \verb+#085+ & \color{#085}{text} & \verb+#08A+ & \color{#08A}{text} & \verb+#08F+ & \color{#08F}{text}  \\
\verb+#580+ & \color{#580}{text} & \verb+#585+ & \color{#585}{text} & \verb+#58A+ & \color{#58A}{text} & \verb+#58F+ & \color{#58F}{text}  \\
\verb+#A80+ & \color{#A80}{text} & \verb+#A85+ & \color{#A85}{text} & \verb+#A8A+ & \color{#A8A}{text} & \verb+#A8F+ & \color{#A8F}{text}  \\
\verb+#F80+ & \color{#F80}{text} & \verb+#F85+ & \color{#F85}{text} & \verb+#F8A+ & \color{#F8A}{text} & \verb+#F8F+ & \color{#F8F}{text}  \\
\hline
\verb+#0F0+ & \color{#0F0}{text} & \verb+#0F5+ & \color{#0F5}{text} & \verb+#0FA+ & \color{#0FA}{text} & \verb+#0FF+ & \color{#0FF}{text}  \\
\verb+#5F0+ & \color{#5F0}{text} & \verb+#5F5+ & \color{#5F5}{text} & \verb+#5FA+ & \color{#5FA}{text} & \verb+#5FF+ & \color{#5FF}{text}  \\
\verb+#AF0+ & \color{#AF0}{text} & \verb+#AF5+ & \color{#AF5}{text} & \verb+#AFA+ & \color{#AFA}{text} & \verb+#AFF+ & \color{#AFF}{text}  \\
\verb+#FF0+ & \color{#FF0}{text} & \verb+#FF5+ & \color{#FF5}{text} & \verb+#FFA+ & \color{#FFA}{text} & \verb+#FFF+ & \color{#FFF}{text}  \\
\hline
\end{array}

\[
\begin{array}{|rrrrrrrr|}
\hline
\verb+#000+ & \color{#000}{text} & \verb+#005+ & \color{#005}{text} & \verb+#00A+ & \color{#00A}{text} & \verb+#00F+ & \color{#00F}{text} \\
\verb+#500+ & \color{#500}{text} & \verb+#505+ & \color{#505}{text} & \verb+#50A+ & \color{#50A}{text} & \verb+#50F+ & \color{#50F}{text} \\
\verb+#A00+ & \color{#A00}{text} & \verb+#A05+ & \color{#A05}{text} & \verb+#A0A+ & \color{#A0A}{text} & \verb+#A0F+ & \color{#A0F}{text} \\
\verb+#F00+ & \color{#F00}{text} & \verb+#F05+ & \color{#F05}{text} & \verb+#F0A+ & \color{#F0A}{text} & \verb+#F0F+ & \color{#F0F}{text} \\
\hline
\verb+#080+ & \color{#080}{text} & \verb+#085+ & \color{#085}{text} & \verb+#08A+ & \color{#08A}{text} & \verb+#08F+ & \color{#08F}{text} \\
\verb+#580+ & \color{#580}{text} & \verb+#585+ & \color{#585}{text} & \verb+#58A+ & \color{#58A}{text} & \verb+#58F+ & \color{#58F}{text} \\
\verb+#A80+ & \color{#A80}{text} & \verb+#A85+ & \color{#A85}{text} & \verb+#A8A+ & \color{#A8A}{text} & \verb+#A8F+ & \color{#A8F}{text} \\
\verb+#F80+ & \color{#F80}{text} & \verb+#F85+ & \color{#F85}{text} & \verb+#F8A+ & \color{#F8A}{text} & \verb+#F8F+ & \color{#F8F}{text} \\
\hline
\verb+#0F0+ & \color{#0F0}{text} & \verb+#0F5+ & \color{#0F5}{text} & \verb+#0FA+ & \color{#0FA}{text} & \verb+#0FF+ & \color{#0FF}{text} \\
\verb+#5F0+ & \color{#5F0}{text} & \verb+#5F5+ & \color{#5F5}{text} & \verb+#5FA+ & \color{#5FA}{text} & \verb+#5FF+ & \color{#5FF}{text} \\
\verb+#AF0+ & \color{#AF0}{text} & \verb+#AF5+ & \color{#AF5}{text} & \verb+#AFA+ & \color{#AFA}{text} & \verb+#AFF+ & \color{#AFF}{text} \\
\verb+#FF0+ & \color{#FF0}{text} & \verb+#FF5+ & \color{#FF5}{text} & \verb+#FFA+ & \color{#FFA}{text} & \verb+#FFF+ & \color{#FFF}{text} \\
\hline
\end{array}
\]


15.5 刪除線


使用刪除線功能必須用 $$ 符號。


在公式內使用 \require{cancel} 來允許 片段刪除線 的顯示。
聲明片段刪除線後,使用 \cancel{字符}、\bcancel{字符}、\xcancel{字符} 和 \cancelto{字符} 來實現各種片段刪除線效果。


$$
\require{cancel}\begin{array}{rl}
\verb|y+\cancel{x}| & y+\cancel{x}\\
\verb|\cancel{y+x}| & \cancel{y+x}\\
\verb|y+\bcancel{x}| & y+\bcancel{x}\\
\verb|y+\xcancel{x}| & y+\xcancel{x}\\
\verb|y+\cancelto{0}{x}| & y+\cancelto{0}{x}\\
\verb+\frac{1\cancel9}{\cancel95} = \frac15+& \frac{1\cancel9}{\cancel95} = \frac15 \\
\end{array}
$$

\[
\require{cancel}\begin{array}{rl}
\verb|y+\cancel{x}| & y+\cancel{x}\\
\verb|\cancel{y+x}| & \cancel{y+x}\\
\verb|y+\bcancel{x}| & y+\bcancel{x}\\
\verb|y+\xcancel{x}| & y+\xcancel{x}\\
\verb|y+\cancelto{0}{x}| & y+\cancelto{0}{x}\\
\verb+\frac{1\cancel9}{\cancel95} = \frac15+& \frac{1\cancel9}{\cancel95} = \frac15 \\
\end{array}
\]


用 \require{enclose} 來允許 整段刪除線 的顯示。
聲明整段刪除線後,使用 \enclose{刪除線效果}{字符} 來實現各種整段刪除線效果。
其中,刪除線效果有 horizontalstrike、verticalstrike、updiagonalstrike 和 downdiagonalstrike,可疊加使用。


$$
\require{enclose}\begin{array}{rl}
\verb|\enclose{horizontalstrike}{x+y}| & \enclose{horizontalstrike}{x+y}\\
\verb|\enclose{verticalstrike}{\frac xy}| & \enclose{verticalstrike}{\frac xy}\\
\verb|\enclose{updiagonalstrike}{x+y}| & \enclose{updiagonalstrike}{x+y}\\
\verb|\enclose{downdiagonalstrike}{x+y}| & \enclose{downdiagonalstrike}{x+y}\\
\verb|\enclose{horizontalstrike,updiagonalstrike}{x+y}| & \enclose{horizontalstrike,updiagonalstrike}{x+y}\\
\end{array}
$$

\[
\require{enclose}\begin{array}{rl}
\verb|\enclose{horizontalstrike}{x+y}| & \enclose{horizontalstrike}{x+y}\\
\verb|\enclose{verticalstrike}{\frac xy}| & \enclose{verticalstrike}{\frac xy}\\
\verb|\enclose{updiagonalstrike}{x+y}| & \enclose{updiagonalstrike}{x+y}\\
\verb|\enclose{downdiagonalstrike}{x+y}| & \enclose{downdiagonalstrike}{x+y}\\
\verb|\enclose{horizontalstrike,updiagonalstrike}{x+y}| & \enclose{horizontalstrike,updiagonalstrike}{x+y}\\
\end{array}
\]


矩陣


1. 無框矩陣


在開頭使用 begin{matrix},在結尾使用 end{matrix},在中間插入矩陣元素,每個元素之間插入 & ,並在每行結尾處使用 \\ 。


$$
        \begin{matrix}
        1 & x & x^2 \\
        1 & y & y^2 \\
        1 & z & z^2 \\
        \end{matrix}
$$

\[
\begin{matrix}
1 & x & x^2 \\
1 & y & y^2 \\
1 & z & z^2 \\
\end{matrix}
\]


2. 邊框矩陣


將 matrix 替換為 pmatrix bmatrix Bmatrix vmatrix Vmatrix 。


$ \begin{matrix} 1 & 2 \\ 3 & 4 \\ \end{matrix} $
$ \begin{pmatrix} 1 & 2 \\ 3 & 4 \\ \end{pmatrix} $
$ \begin{bmatrix} 1 & 2 \\ 3 & 4 \\ \end{bmatrix} $
$ \begin{Bmatrix} 1 & 2 \\ 3 & 4 \\ \end{Bmatrix} $
$ \begin{vmatrix} 1 & 2 \\ 3 & 4 \\ \end{vmatrix} $
$ \begin{Vmatrix} 1 & 2 \\ 3 & 4 \\ \end{Vmatrix} $

matrix pmatrix bmatrix Bmatrix vmatrix Vmatrix
\( \begin{matrix} 1 & 2 \\ 3 & 4 \\ \end{matrix} \) \( \begin{pmatrix} 1 & 2 \\ 3 & 4 \\ \end{pmatrix} \) \( \begin{bmatrix} 1 & 2 \\ 3 & 4 \\ \end{bmatrix} \) \( \begin{Bmatrix} 1 & 2 \\ 3 & 4 \\ \end{Bmatrix} \) \( \begin{vmatrix} 1 & 2 \\ 3 & 4 \\ \end{vmatrix} \) \( \begin{Vmatrix} 1 & 2 \\ 3 & 4 \\ \end{Vmatrix} \)

3. 帶省略符號的矩陣


用 \cdots \(\cdots\) , \ddots \(\ddots\) , \vdots \(\vdots\) 輸入省略符號。


ex:


$$
        \begin{pmatrix}
        1 & a_1 & a_1^2 & \cdots & a_1^n \\
        1 & a_2 & a_2^2 & \cdots & a_2^n \\
        \vdots & \vdots & \vdots & \ddots & \vdots \\
        1 & a_m & a_m^2 & \cdots & a_m^n \\
        \end{pmatrix}
$$

\[
\begin{pmatrix}
1 & a_1 & a_1^2 & \cdots & a_1^n \\
1 & a_2 & a_2^2 & \cdots & a_2^n \\
\vdots & \vdots & \vdots & \ddots & \vdots \\
1 & a_m & a_m^2 & \cdots & a_m^n \\
\end{pmatrix}
\]


4. 帶分割符號的矩陣


cc|c 代表在一個三列矩陣中的第二和第三列之間插入分割線。


$$
\left[
    \begin{array}{cc|c}
      1&2&3\\
      4&5&6
    \end{array}
\right]
$$

\[
\left[
\begin{array}{cc|c}
1&2&3\\
4&5&6
\end{array}
\right]
\]


5. 行內矩陣


\bigl(\begin{smallmatrix} ... \end{smallmatrix}\bigr)


ex:


這是一個行內矩陣 $\bigl( \begin{smallmatrix} a & b \\ c & d \end{smallmatrix} \bigr)$ 。

這是一個行內矩陣 \(\bigl( \begin{smallmatrix} a & b \\ c & d \end{smallmatrix} \bigr)\) 。


方程式


1. 方程式序列


用 \begin{align}…\end{align} 來創造一列方程式,其中在每行結尾處使用 \\ 。


請注意 {align} 語句是 自動編號。


\begin{align}
\sqrt{37} & = \sqrt{\frac{73^2-1}{12^2}} \\
 & = \sqrt{\frac{73^2}{12^2}\cdot\frac{73^2-1}{73^2}} \\
 & = \sqrt{\frac{73^2}{12^2}}\sqrt{\frac{73^2-1}{73^2}} \\
 & = \frac{73}{12}\sqrt{1 - \frac{1}{73^2}} \\
 & \approx \frac{73}{12}\left(1 - \frac{1}{2\cdot73^2}\right)
\end{align}

\[
\begin{align}
\sqrt{37} & = \sqrt{\frac{73^2-1}{12^2}} \\
& = \sqrt{\frac{73^2}{12^2}\cdot\frac{73^2-1}{73^2}} \\
& = \sqrt{\frac{73^2}{12^2}}\sqrt{\frac{73^2-1}{73^2}} \\
& = \frac{73}{12}\sqrt{1 - \frac{1}{73^2}} \\
& \approx \frac{73}{12}\left(1 - \frac{1}{2\cdot73^2}\right)
\end{align}
\]


2. 在方程式序列的每一行中注明原因


在 {align} 中靈活組合 \text 和 \tag 語句。\tag 語句編號優先級高於自動編號。


\begin{align}
   v + w & = 0  &\text{Given} \tag 1\\
   -w & = -w + 0 & \text{additive identity} \tag 2\\
   -w + 0 & = -w + (v + w) & \text{equations $(1)$ and $(2)$}
\end{align}

\[
\begin{align}
v + w & = 0 &\text{Given} \tag 1\\
-w & = -w + 0 & \text{additive identity} \tag 2\\
-w + 0 & = -w + (v + w) & \text{equations $(1)$ and $(2)$}
\end{align}
\]


條件表達式


1. 條件表達式


使用 begin{cases} 來創造一組條件表達式,在每一行條件中插入 & 來指定需要對齊的內容,並在每一行結尾處使用 \\,以 end{cases} 結束。


$$
        f(n) =
        \begin{cases}
        n/2,  & \text{if $n$ is even} \\
        3n+1, & \text{if $n$ is odd}
        \end{cases}
$$

\[
f(n) =
\begin{cases}
n/2, & \text{if $n$ is even} \\
3n+1, & \text{if $n$ is odd}
\end{cases}
\]


2. 左側對齊的條件表達式


$$
        \left.
        \begin{array}{l}
        \text{if $n$ is even:}&n/2\\
        \text{if $n$ is odd:}&3n+1
        \end{array}
        \right\}
        =f(n)
$$

\[
\left.
\begin{array}{l}
\text{if $n$ is even:}&n/2\\
\text{if $n$ is odd:}&3n+1
\end{array}
\right\}
=f(n)
\]


3. 讓條件表達式調整行高


在一些情況下,條件表達式中某些行的行高為非標準高度,此時使用 \\[2ex] 語句代替該行末尾的 \\ 來讓編輯器自動調整。


$$
f(n) =
\begin{cases}
\frac{n}{2},  & \text{if $n$ is even} \\
3n+1, & \text{if $n$ is odd}
\end{cases}
$$

\[
f(n) =
\begin{cases}
\frac{n}{2}, & \text{if $n$ is even} \\
3n+1, & \text{if $n$ is odd}
\end{cases}
\]


調整行高的結果


$$
f(n) =
\begin{cases}
\frac{n}{2},  & \text{if $n$ is even} \\[2ex]
3n+1, & \text{if $n$ is odd}
\end{cases}
$$

\[
f(n) =
\begin{cases}
\frac{n}{2}, & \text{if $n$ is even} \\[2ex]
3n+1, & \text{if $n$ is odd}
\end{cases}
\]


數組與表格


1. 如何輸入一個數組或表格


通常,一個格式化後的表格比單純的文字或排版後的文字更具有可讀性。數組和表格均以 begin{array} 開頭,並在其後定義列數及每一列的文本對齊屬性,c l r 分別代表居中、左對齊及右對齊。若需要插入垂直分割線,在定義式中插入 | ,若要插入水平分割線,在下一行輸入前插入 \hline 。與矩陣相似,每行元素間均須要插入 & ,每行元素以 \\ 結尾,最後以 end{array} 結束數組。


\begin{array}{c|lcr}
n & \text{左} & \text{置中} & \text{右} \\
\hline
1 & 0.24 & 1 & 125 \\
2 & -1 & 189 & -8 \\
3 & -20 & 2000 & 1+10i
\end{array}

\[
\begin{array}{c|lcr}
n & \text{左} & \text{置中} & \text{右} \\
\hline
1 & 0.24 & 1 & 125 \\
2 & -1 & 189 & -8 \\
3 & -20 & 2000 & 1+10i
\end{array}
\]


2. 嵌套的數組或表格


多個數組/表格可 互相嵌套 並組成一組數組/一組表格。
使用嵌套前必須聲明 $$ 符號。


$$
% outer vertical array of arrays 外層垂直表格
\begin{array}{c}
    % inner horizontal array of arrays 內層水平表格
    \begin{array}{cc}
        % inner array of minimum values 內層"最小值"數組
        \begin{array}{c|cccc}
        \text{min} & 0 & 1 & 2 & 3\\
        \hline
        0 & 0 & 0 & 0 & 0\\
        1 & 0 & 1 & 1 & 1\\
        2 & 0 & 1 & 2 & 2\\
        3 & 0 & 1 & 2 & 3
        \end{array}
    &
        % inner array of maximum values 內層"最大值"數組
        \begin{array}{c|cccc}
        \text{max}&0&1&2&3\\
        \hline
        0 & 0 & 1 & 2 & 3\\
        1 & 1 & 1 & 2 & 3\\
        2 & 2 & 2 & 2 & 3\\
        3 & 3 & 3 & 3 & 3
        \end{array}
    \end{array}
    % 內層第一行表格組結束
    \\
    % inner array of delta values 內層第二行Delta值數組
        \begin{array}{c|cccc}
        \Delta&0&1&2&3\\
        \hline
        0 & 0 & 1 & 2 & 3\\
        1 & 1 & 0 & 1 & 2\\
        2 & 2 & 1 & 0 & 1\\
        3 & 3 & 2 & 1 & 0
        \end{array}
        % 內層第二行表格組結束
\end{array}
$$

\[
\begin{array}{c}
\begin{array}{cc}
\begin{array}{c|cccc}
\text{min} & 0 & 1 & 2 & 3\\
\hline
0 & 0 & 0 & 0 & 0\\
1 & 0 & 1 & 1 & 1\\
2 & 0 & 1 & 2 & 2\\
3 & 0 & 1 & 2 & 3
\end{array}
&
\begin{array}{c|cccc}
\text{max}&0&1&2&3\\
\hline
0 & 0 & 1 & 2 & 3\\
1 & 1 & 1 & 2 & 3\\
2 & 2 & 2 & 2 & 3\\
3 & 3 & 3 & 3 & 3
\end{array}
\end{array}
\\
\begin{array}{c|cccc}
\Delta&0&1&2&3\\
\hline
0 & 0 & 1 & 2 & 3\\
1 & 1 & 0 & 1 & 2\\
2 & 2 & 1 & 0 & 1\\
3 & 3 & 2 & 1 & 0
\end{array}
\end{array}
\]


3. 方程組


\begin{array}…\end{array} 和 \left\{…\right.


$$
\left\{
\begin{array}{c}
a_1x+b_1y+c_1z=d_1 \\
a_2x+b_2y+c_2z=d_2 \\
a_3x+b_3y+c_3z=d_3
\end{array}
\right.
$$

\[
\left\{
\begin{array}{c}
a_1x+b_1y+c_1z=d_1 \\
a_2x+b_2y+c_2z=d_2 \\
a_3x+b_3y+c_3z=d_3
\end{array}
\right.
\]


或者使用條件表達式組 \begin{cases}…\end{cases} 來實現相同效果


\begin{cases}
a_1x+b_1y+c_1z=d_1 \\
a_2x+b_2y+c_2z=d_2 \\
a_3x+b_3y+c_3z=d_3
\end{cases}

\[
\begin{cases}
a_1x+b_1y+c_1z=d_1 \\
a_2x+b_2y+c_2z=d_2 \\
a_3x+b_3y+c_3z=d_3
\end{cases}
\]


連分數


用 \cfrac


$$
x = a_0 + \cfrac{1^2}{a_1
          + \cfrac{2^2}{a_2
          + \cfrac{3^2}{a_3 + \cfrac{4^4}{a_4 + \cdots}}}}
$$

\[
x = a_0 + \cfrac{1^2}{a_1
+ \cfrac{2^2}{a_2
+ \cfrac{3^2}{a_3 + \cfrac{4^4}{a_4 + \cdots}}}}
\]


可以使用 \frac 來表達連分數的 緊縮記法 。


$$
x = a_0 + \frac{1^2}{a_1+}
          \frac{2^2}{a_2+}
          \frac{3^2}{a_3 +} \frac{4^4}{a_4 +} \cdots
$$

\[
x = a_0 + \frac{1^2}{a_1+}
\frac{2^2}{a_2+}
\frac{3^2}{a_3 +} \frac{4^4}{a_4 +} \cdots
\]


交換圖表


使用一行 $ \require{AMScd} $ 語句來允許交換圖表的顯示。
宣告交換圖表後,語法與矩陣相似,在開頭使用 begin{CD},在結尾使用 end{CD},在中間插入圖表元素,每個元素之間插入 & ,並在每行結尾處使用 \\ 。


$\require{AMScd}$
\begin{CD}
    A @>a>> B\\
    @V b V V\# @VV c V\\
    C @>>d> D
\end{CD}$

\[
$\require{AMScd}$
\begin{CD}
A @>a>> B\\
@V b V V\# @VV c V\\
C @>>d> D
\end{CD}$
\]


@>>>代表右箭頭、@<<<代表左箭頭、@VVV代表下箭頭、@AAA代表上箭頭、@=代表水平雙實線、@|代表竪直雙實線、@.代表沒有箭頭。
在
@>>>的>>>` 之間任意插入文字即代表該箭頭的注釋文字。


$\require{AMScd}$
\begin{CD}
    A @>>> B @>{\text{very long label}}>> C \\
    @. @AAA @| \\
    D @= E @<<< F
\end{CD}

\[
$\require{AMScd}$
\begin{CD}
A @>>> B @>{\text{very long label}}>> C \\
@. @AAA @| \\
D @= E @<<< F
\end{CD}
\]


注意事項


  • 在以e為底的指數函數、極限和積分中盡量不要使用 \frac 符號:它會使整段函數看起來很怪,而且可能產生歧義。也正是因此它在專業數學排版中幾乎從不出現。
    橫著寫這些分式,中間使用斜線間隔 / (用斜線代替分數線)。

\begin{array}{cc}
\mathrm{Bad} & \mathrm{Better} \\
\hline \\
e^{i\frac{\pi}2} \quad e^{\frac{i\pi}2}& e^{i\pi/2} \\
\int_{-\frac\pi2}^\frac\pi2 \sin x\,dx & \int_{-\pi/2}^{\pi/2}\sin x\,dx \\
\end{array}

\(\begin{array}{cc}
\mathrm{Bad} & \mathrm{Better} \\
\hline \\
e^{i\frac{\pi}2} \quad e^{\frac{i\pi}2}& e^{i\pi/2} \\
\int_{-\frac\pi2}^\frac\pi2 \sin x\,dx & \int_{-\pi/2}^{\pi/2}\sin x\,dx \\
\end{array}\)


  • 符號在被當作分隔符時會產生錯誤的間隔,因此在需要分隔時最好使用 \mid 來代替它。

\begin{array}{cc}
\mathrm{Bad} & \mathrm{Better} \\
\hline \\
\{x|x^2\in\Bbb Z\} & \{x\mid x^2\in\Bbb Z\} \\
\end{array}

\(\begin{array}{cc}
\mathrm{Bad} & \mathrm{Better} \\
\hline \\
\{x|x^2\in\Bbb Z\} & \{x\mid x^2\in\Bbb Z\} \\
\end{array}\)


  • 使用多重積分符號時,不要多次使用 \int ,直接使用 \iint 來表示 二重積分 ,使用 \iiint 來表示 三重積分 等。對於無限次積分,可以用 \int \cdots \int 表示。

\begin{array}{cc}
\mathrm{Bad} & \mathrm{Better} \\
\hline \\
\int\int_S f(x)\,dy\,dx & \iint_S f(x)\,dy\,dx \\
\int\int\int_V f(x)\,dz\,dy\,dx & \iiint_V f(x)\,dz\,dy\,dx
\end{array}

\(\begin{array}{cc}
\mathrm{Bad} & \mathrm{Better} \\
\hline \\
\int\int_S f(x)\,dy\,dx & \iint_S f(x)\,dy\,dx \\
\int\int\int_V f(x)\,dz\,dy\,dx & \iiint_V f(x)\,dz\,dy\,dx
\end{array}\)


  • 在微分符號前加入 \, 來插入一個小的間隔空隙;沒有 \, 符號的話,latex 將會把不同的微分符號堆在一起。

\begin{array}{cc}
\mathrm{Bad} & \mathrm{Better} \\
\hline \\
\iiint_V f(x){\rm d}z {\rm d}y {\rm d}x & \iiint_V f(x)\,{\rm d}z\,{\rm d}y\,{\rm d}x
\end{array}

\(\begin{array}{cc}
\mathrm{Bad} & \mathrm{Better} \\
\hline \\
\iiint_V f(x){\rm d}z {\rm d}y {\rm d}x & \iiint_V f(x)\,{\rm d}z\,{\rm d}y\,{\rm d}x
\end{array}\)


Reference


如何在markdown中插入公式


MarkDown公式輸入


Cmd Markdown 公式指導手冊


數學符號的意義與念法

2020/2/3

ASR Automatic_Speech_Recognition


語音辨識


ref: 微軟Edx語音識別課程


  1. 語音信號處理
  2. 聲學模型
  3. 語言模型
  4. 解碼器

語音活動偵測 VAD


  • 聲學特徵分析


    將聲音波形只代表聲壓隨時間變化的關係,必須將波形轉成聲學特徵向量:MFCC, LPCC, MRCG

  • 以 MRCG 為基礎的分類器,以 tensorlfow (python 實作)


    1. ACAM 自我調整上下文關注模型
    2. bDNN 增強的深度神經網路
    3. DNN 深度神經網路
    4. LSTM-RNN 長短期記憶遞迴神經網路

標記語言


可用 IPA 或 SAMPA


SAMPA 是電腦讀取的語音字母表,包含將國際音標對應到 33~127 的 ASCII code


可用 audacity 標註音軌


可用 PRAAT 標記音節邊界


端點偵測 End-Point Detection


可自動檢測語音的起始及結束點。


可用雙門檻比較法進行端點偵測。以短時能量 E 和短時平均過零率 Z 作為特徵,進行端點偵測。


6-1 Introduction to End-Point Detection (端點偵測介紹)


常見的端點偵測方法與相關的特徵參數,可以分成兩大類:


  1. 時域(Time Domain)的方法:計算量比較小,因此比較容易移植到計算能力較差的微電腦平台。

    1. 音量:只使用音量來進行端點偵測,是最簡單的方法,但是會對氣音造成誤判。不同的音量計算方式也會造成端點偵測結果的不同,至於是哪一種計算方式比較好,並無定論,需要靠大量的資料來測試得知。
    2. 音量和過零率:以音量為主,過零率為輔,可以對氣音進行較精密的檢測。
  2. 頻域(Frequency Domain)的方法:計算量比較大,因此比較難移植到計算能力較差的微電腦平台。

    1. 頻譜的變異數:有聲音的頻譜變化較規律,變異數較低,可作為判斷端點的基準。
    2. 頻譜的Entropy:我們也可以使用使用 Entropy 達到類似上述的功能。

若只是對聲音波形做一些較簡單的運算,就是屬於時域的方法。另一方面,凡是要用到傅立葉轉換(Fourier Transform)來產生聲音的頻譜,就是屬於頻譜的方法。這種分法常被用來對音訊處的方法進行分類,但有時候有一些模糊地帶。有關於頻譜以及傅立葉轉換,會在後續的章節說明。


Sphinx Voice Activity Detection


端點偵測介紹


錯誤的端點偵測,在語音辨識上會造成兩種效應:


  • False Rejection:將 Speech 誤認為 Silence/Noise,因而造成音訊辨識率下降
  • False Acceptance:將 Silence/Noise 誤認為 Speech,此時音訊辨識率也會下降,但是我們可以在設計辨識器時,前後加上可能的靜音聲學模型,此時辨識率的下降就會比前者來的和緩。

動態時間規劃


Dynamic Time Warping(DTW)動態時間規整演算法


Dynamic Time Warping(DTW)是一種衡量兩個時間序列之間的相似度的方法,主要應用在語音識別領域來識別兩段語音是否表示同一個單詞。


在時間序列中,需要比較相似性的兩段時間序列的長度可能並不相等,在語音識別領域表現為不同人的語速不同。而且同一個單詞內的不同音素的發音速度也不同,比如有的人會把“A”這個音拖得很長,或者把“i”發的很短。另外,不同時間序列可能僅僅存在時間軸上的位移,亦即在還原位移的情況下,兩個時間序列是一致的。在這些複雜情況下,使用傳統的歐幾里得距離無法有效地求的兩個時間序列之間的距離(或者相似性)。


DTW通過把時間序列進行延伸和縮短,來計算兩個時間序列性之間的相似性:


SH專區 - Dynamic Time Warping(動態時間規劃) 1


最基礎的DTW計算其實相當直覺,就是建構一個「點對點」的distance matrix,然後由起點一步一步的向終點邁進。在前進的時候,只有一個條件:挑選最短路徑。


數位語音資料


ref: Audio


要讓電腦處理聲音,必須預先讓聲音變成數字,也就是讓聲音經過「取樣 sampling 」與「量化 quantization 」兩個步驟。取樣把時間變成離散,量化把振幅 amplitude 變成離散。


先取樣(得到數列),再量化(四捨五入),最後得到一串整數數列。每個數字稱作「樣本 sample 」或「訊號 signal 」。


duration 持續時間:聲音總共多少秒。數值越高,訊號越多。


sampling rate 取樣頻率:一秒鐘有多少個訊號。數值越高,音質越好。電腦的聲音檔案,通常採用 48000Hz 或 44100Hz 。手機與電話的聲音傳輸,公定為 8000Hz 。


bit depth 位元深度:一個訊號用多少個位元記錄。數值越高,音質越好。電腦的聲音檔案,通常採用 16-bit 或 24-bit 。 16-bit 的每個訊號是 [-32768,+32767] 的整數,符合 C 語言的 short 變數。


channel 聲道:同時播放的聲音訊號總共幾條。每一條聲音訊號都是一樣長。舉例來說,民眾所熟悉的雙聲道,其實就是同時播出兩條不同的聲音訊號。


取樣頻率、持續時間、聲道,相乘之後就是訊號數量。再乘以位元深度,就是容量大小。再除以 8 ,可將單位換成 byte 。


順帶一提,不管是聲音或者是其他信息,只要是經過取樣與量化得到的資料,總稱 PCM data 。「脈衝編碼調變 pulse-code modulation, PCM 」源自訊號學,所以名稱才會如此不直覺。


各種聲音資料的位元深度不盡相同。統合方式:採用 32-bit 浮點數,讀檔後將訊號數值縮放成 [-1,+1] ,才進行聲音處理;存檔前調回原本範圍。


Amplitude 振幅


聲音訊號的數值,代表空氣振動的幅度。基準訂為 0 ,範圍訂為 ±32767 (當位元深度是 16-bit )。


振幅高,聽起來大聲。振幅低,聽起來小聲。


Frequency 頻率


人類擅於感受的不是振動的幅度,而是振動的頻率。頻率高,聽起來尖銳。頻率低,聽起來低沉。


取樣定理: x Hz 的波,取樣頻率至少要是 2x Hz ,才能明確分辨上下次數,頻率保持相同(而振幅總是失真)。也就是說,取樣頻率 48000Hz ,頂多只能記錄 24000Hz 以下的聲音。但是別擔心,人類聽覺範圍是 20Hz 至 20000Hz 。


frame 訊框


訊號很長,變化很大,因此必須將訊號分成小段處理,使得小段之內變化很小。每個小段都稱作一個「框」或「幀」。


當取樣頻率是 48000Hz 、框是 512 個訊號,則此框佔有 512/48000 ≈ 0.01 秒,人耳無法分辨這麼短時間的變化,人聲也無法控制這麼短時間的變化,可以說是足夠細膩了。


為了讓變化更連續,於是讓框交疊。


Fourier Transform


振動十分複雜,難以測量頻率。計算學家的共識是:運用離散版本 Fourier Transform ,將訊號數值分解成簡諧波,解析頻率。因為簡諧波是最漂亮的振動方式,所以適合當作公定標準。


spectrum 頻譜:一個特定時間點的頻率分佈圖。


實務上的做法是:截取一小段時間範圍的訊號,實施快速傅立葉轉換,得到每一種頻率的波的強度、相位。


比如 48000Hz 的取樣頻率、 256 點訊號,則頻譜總共 256 種頻率。第一種頻率是 0Hz ,接著每一種頻率相差 48000Hz / 256 = 187.5Hz 。前 128 種、後 128 種左右對稱,後 128 種沒有實際作用。呼應取樣定理,資訊量只剩一半


spectrogram 頻譜圖:所有時間點的頻率分佈圖。


Window


原本完整的聲音波形,硬生生被框截斷,頻譜將產生誤差。解法:將框的兩端的訊號漸漸減弱,減少影響。也就是乘上一個中央高、兩側低的函數,數值皆介於零到一之間,稱作「窗函數 Window Function 」。


Filter 濾波器


頻譜是分析聲音的工具。濾波器則是修改聲音的工具。例如刪除聲音的高頻部分,稱做 lowpass filter 。


濾波器有時域與頻域兩大類。


時域濾波器,直接的修改訊號。計算速度飛快,但是需要「數位訊號處理」的數學知識。例如 shelving filter 。


頻域濾波器,間接的修改頻譜。原訊號 FFT 得到頻譜,修改頻譜(例如把低頻的強度和相位調成 0 ,形成 highpass filter ),再 IFFT 得到新訊號。


peak detection


找到波形的尖峰。


消除鋸齒:方法很多,諸如
* 時域的平滑效果(k點平均值)(k點中位數)。
* 頻域的刪除高頻(高頻形成鋸齒)。
* 時域的Linear Prediction(迴歸函數)。


frequency detection


找到波形的頻率。


  • 時域的方法
    peak detection:找到兩個波峰,位置相減得到波長,波長倒數得到頻率。僅適合純音。
    zero-crossing rate:波形穿越零的次數。僅適合純音。
    ACF:位移、相乘、加總(內積)。各種位移量,找最大值。
    AMDF:位移、相減再絕對值、加總(絕對值誤差)。各種位移量,找最小值。
    YIN:位移、相減再平方、加總(平方誤差)。各種位移量,除以前綴和,找最小值。
    複合:例如 ACF / (AMDF + 1.0),找最大值。

  • 頻域的方法
    peak detection:找到強度最高的頻率。計算速度較慢。


語音處理


gain :音量放大(縮小)。振幅乘上倍率。波形於垂直方向伸展或壓扁。


normalization :校準聲音波形,中央為 0 ,最高振幅為 1 。等同於聲音儘量調到最大聲。


pre-emphasis :有時候錄音環境不佳,錄製到的聲音濛濛霧霧。微分運算可使聲音清晰。副作用是音量下降。


smoothing :有時候錄音環境不佳,錄製到的聲音唧唧吱吱。平均值可抑制雜訊。副作用是聲音模糊不清、音量下降。


mixing :混音。混和好幾道聲音。其實就是加權平均值。


echo :回聲。相同聲音稍後再度出現。其實就是延遲與混音(位移與疊加)。


reverb :迴響。餘音繞樑。反覆回音,間隔極短。聽起來彷彿位於寬敞的密閉空間。


pitch shifting :移調。改變頻率。


chorus :合唱。混和好幾道聲音,每道聲音的頻率略有變動、延遲時間略有差異。


robot sound :簡易做法是混和兩道聲音,頻率略高、頻率略低的聲音。


harmonics :和聲。混和好幾道聲音,每道聲音的頻率皆不同。


distortion :失真。降低聲音品質,聽起來像破音。


equalization :調整每個頻帶的音量,使得聽起來均勻。套用許多個濾波器即可。


pitch bending :轉音。頻率平滑地增減(頻譜的強度平滑地位移)。


morphing :一種聲音,平滑柔順地轉化成另一種聲音。推測是每個頻帶各自轉音。


Fourier transform


聲音訊號可分解為不同振幅、頻率、相位的波覆蓋。波的相位可用複數表示。


離散傅立葉轉換 DFT 是一個將 n 個複數的向量,對應到 n 個複數的另一個向量的函數。


\(X(k)=\sum_{t=0}^{N-1} x(t) e^{-i2 \pi \frac{tk}{N}}, k=0, ..., N-1\)


向量 x 是個時間點的訊號水平


向量 X 是個頻率下的訊號水平


這個公式的意思是,在頻率 k 處的訊號水平等於每個時間 t 的訊號水平 * 複數指數的總和


尤拉公式: 對任意實數 x : \( e^{xi} = cosx + i sinx \)


cos 是偶函數,因此 \( cos(-x) = cosx\)


sin 是奇函數,因此 \( sin(-x)=-sinx\)


\( e^{-i2 \pi \frac{tk}{N}} = e^{(-2 \pi \frac{tk}{N})i} = cos(-2\pi \frac{tk}{N}) + i sin(-2 \pi \frac{tk}{N}) = cos(2\pi \frac{tk}{N}) - i sin(2 \pi \frac{tk}{N}) \)


\( x= Re(x) + i Im(x)\) Re: 實部 Im: 虛部


\( x(t) e^{-i2 \pi \frac{tk}{N}} = [Re(x(t)) + i Im(x(t))][cos(2\pi \frac{tk}{N}) - i sin(2 \pi \frac{tk}{N})]\)


兩個複數相乘


\( x(t) e^{-i2 \pi \frac{tk}{N}} = [Re(x(t))cos(2\pi \frac{tk}{N}) + Im(x(t))sin(2 \pi \frac{tk}{N})] + i[-Re(x(t))sin(2 \pi \frac{tk}{N}) + Im(x(t)) cos(2 \pi \frac{tk}{N})]\)


Fourier Cosine Transform


N 個波,頻率是 0 倍、 0.5 倍、 1 倍、 1.5 倍、 …… ,分別是 cos((2π/N)⋅0⋅t) 、 cos((2π/N)⋅0.5⋅t) 、 cos((2π/N)⋅1⋅t) 、 …… 。寫成代數是 cos((2π/N)⋅(f/2)⋅t) 。


輸入數列與一個波,置中對齊。 N 個對應位置,相乘後求和(點積),得到一個輸出數值。


輸入數列,分別投影至 N 個波,得到 N 個輸出數值,形成輸出數列。這就是餘弦轉換。


正向餘弦轉換:一個複雜的波,拆解成 N 個平穩的波,頻率是 0 倍開始漸增 0.5 倍,振幅是 N 個輸出數值,相位都是 0 。


逆向餘弦轉換: N 個平穩的波,頻率是 0 倍開始漸增 0.5 倍,分別乘上振幅,疊加成一個複雜的波。


DFT 時間複雜度為 O(n^2)


1965 提出了一個 Cooley-Turkey Fast Fourier 演算法,以 divide-and-conquer 為方法,遞迴地將長度 \(N=N_1N_2\) 的 DST 轉換分解為長度 \(N_1\) 的 \(N_2\) 個較短序列的 DST,以及 O(N) 個旋轉因數的複數乘法


MFCC 特徵


  • 輸入 16kHz 音訊
  • 以 25ms 的 window,每次移動 10ms 輸出一個向量數列,產生數值數列
  • 乘上 windows 函數 (ex: 漢明距離)
  • 執行 FFT
  • 在每個頻率桶中記錄能量,也就是計算每個頻率區間的能量
  • 執行 DCT 離散餘弦轉換,得到 「倒譜」
  • 保留倒譜的前 13 個係數

深度學習可直接使用聲音的 wav file,不使用 MFCC


說話特徵


不同 speaker 在一個通用聲學簇內具有不同的子空間。


由通用簇偏移的子空間,描述了樣本的方向向量,取決於說話者的語言文字。


為取得相關的(含說話者) 的特徵,將這些向量分析為特徵因數。分析的因數特徵稱為身份向量 (identity vectors: I-vectors)。 i-vectors 就是說話者的特徵,可用來辨識說話者。(ex: 利用兩個語音向量的餘弦距離,作為兩段語音是否來自同一個說話者的衡量指標)


解碼


kaldi 工具中,沒有單一標準解碼器,或滿足固定介面的解碼器


目前有 SimpleDecoder 與 FasterDecoder 解碼器,及詞圖產生解碼器。有 command line tool 封裝這些解碼器,他們可解碼特定類型的模型 (ex: GMM) 或具有特定的特殊條件 (ex: 多類別 fMLLR)


解碼的 command 為 gmm-decode-simple, gmm-decode-faster, gem-decode-kaldi, gmm-decode-faster-fmllr。目前不提供可執行所有可能類型的解碼指令


語言模型


語音辨識是使用語言模型解碼識別結果。以下是 機率語言模型 & 語言模型套件 KenLM


機率語言模型


輸入語音序列 「已經還了」


兩種辨識結果,要如何評價?


\(S_1\) 已經/還/了


\(S_2\) 已經/黃/了


根據條件機率 \(P(S_1|C), P(S_2|C)\) 的值決定選擇哪一個


貝氏定理 \(P(C∩S) = P(S|C)P(C)=P(C|S)P(S)\) -> \(P(S|C) = \frac{P(C|S)P(S)}{P(C)}\)


\(P(C)\) 是字串在語料庫中出現的機率。 ex: 語料庫有一萬個句子,其中一句:「生命的意義是什麼」,\(P(C)=P("生命的意義是什麼")=0.0001\) 。


因字串恢復到中文字串的機率只有唯一一種,所以 \(P(C|S)=1\)


比較 \(P(S_1|C), P(S_2|C)\) 的大小,變成比較 \(P(S_1), P(S_2)\) 的大小,因為 \(\frac{P(S_1|C)}{P(S_2)|C} = \frac {P(S_1)}{P(S_2)}\)


\(P(S_1 已經/還/了) > P(S_2 已經/黃/了)\) 所以選擇 \(S_1\)


機率語言模型是用來評估指定詞序列 S 的機率 P(S),為簡化計算,假設每個詞之間的機率跟上下文無關


\(P(S)=P(w_1, w_2, .... w_r) = P(w_1)P(w_2)...P(w_r)\) 其中 \(P(w)\) 是詞 w 出現在語料庫中的機率


ex: \( P(S_1 已經/還/了) = P(已經) P(還) P(了)\)


因為詞表中的詞很多,分配到一個詞的機率很小,所以 \(P(S)\) 會是很多很小的數值的乘積。因此利用對數 \(y=log(x)\) 進行轉換,取對數後,表示一個小於 1 的正數的精確度加強了


\(P(S) = P(w_1)P(w_2)...P(w_r) => logP(w_1) logP(w_2)... logP(w_r)\)


因為機率小於 1 ,取對數後是負數


計算任一個詞出現的機率為 \(P(w_1) = \frac {w_1在語料庫出現的次數 n}{語料庫的總詞數 N}\) ,因此 \( logP(w_1) = log(freq_w) - logN\)


如果已經先算出詞機率的對數值,結果可直接用加法,得到 \(logP(S)\)


這個 \(P(S)\) 公式,就是一元機率語言模型為基礎的計算公式


一元模型


假設語料庫有 10000 個詞,其中 「了」出現了 180 次,則機率為 0.018


詞語 詞頻 概率
了 180 0.0180
還 5 0.0005
已經 10 0.0010
黃 2 0.0002

\(P(S_1) = P(已經)P(還)P(了) = 0.001*0.0005*0.018 = 9*10^{-9}\)


\(P(S_2) = P(已經)P(黃)P(了) = 0.001*0.0002*0.018 = 3.6*10^{-9}\)


因為 \(P(S_1) > P(S_2)\) 故選擇 \(S_1\)


取對數的計算:


\(logP(S_1) = logP(已經)logP(還)logP(了) = -18.52604\)


\(logP(S_2) = logP(已經)logP(黃)logP(了) = -19.44233199\)


結果一樣 \(logP(S_1) > logP(S_2)\)


資料基礎


機率語言需要知道哪些是高頻詞,哪些是低頻詞,也就是


\(P(w) = \frac {freq(w)}{所有詞的總次數}\)


詞語機率表是由語料庫統計出來的。為支援中文分詞方法,需要增加分詞資料庫


從分詞語料庫加工出人工可以編輯的一元詞典。一元的英文是 Unigram,一元詞典就稱為 UnigramDic


UnigramDic.txt sample:


有: 180
有意: 5
意見: 10
見: 2
分歧: 1
大學生: 139
生活: 1671

可根據 UnigramDic.txt 產生一元詞典樹


為快速產生詞典樹,可把結構儲存下來。


以 Depth First 方式,對每個節點編號,沒有孩子的分支節點編號為 -1。根據編號,以 節點編號#左邊孩子節點的編號#中間孩子節點的編號#右邊孩子節點的編號#節點本身的資料 的格式,儲存節點之間的關係資料。


0#1#2#3#有
1#4#5#6#基
2#7#8#9#道

改進一元模型


計算最佳前驅節點到目前節點的傳輸機率,考慮更前面的切分路徑。


以 \(P(w_i|w_{i-1})\) 的值代替 \(P(W_i)\)


如果用最大似然估計 \(P(w_i|w_{i-1})\) ,則 \(P(w_i|w_{i-1}) = \frac {freq(w_{i-1}, w_i)}{freq(w_{i-1})}\)


ex: \(freq(有,意見) = 4\),則 \(P(意見|有) = freq(有, 意見)/freq(有) = 4/4000 = 0.001\)


ex: 語料庫中存在 「北京/舉行/新年/音樂會」,就存在了一元連結。存在二元連結:北京@舉行, 舉行@新年, 新年@音樂會。


可從語料庫統計前後兩個詞一起出現的次數


如果 「意見, 分歧」 沒找到其他搭配的詞, \(P(S_1), P(S_2)\) 都是 0,無法透過比較計算結果,找到更好的切分方案,這是零機率問題。


使用 \(freq(w_{i-1}, w_i)/freq(w_{i-1})\) 估計 \(P(w_i|w_{i-1})\)


使用 \(freq(w_{i-2}, w_{i-1}, w_i)/freq(w_{i-2}, w_{i-1})\) 估計 \(P(w_i|w_{i-2}, w_{i-1})\)


因為使用了最大似然估計法,所以把 \(freq(w_{i-1}, w_i)/freq(w_{i-1})\) 稱為 \(P_{ML}(w_i|w_{i-1})\)


\(P_{l_i}(w_i|w_{i-1}) = 𝜆_1 P_{ML}(w_i) + 𝜆_2 P_{ML}(w_i|w_{i-1}) = 𝜆_1(freq(w_i)/N) + 𝜆_2(freq(w_{i-1}, w_i) / freq(w_{i-1}))\)


對於 \(P_{l_i}(w_i|w_{i-2}, w_{i-1})\) 則是


\(P_{l_i}(w_i|w_{i-2}, w_{i-1}) = 𝜆_1 P_{ML}(w_i) + 𝜆_2 P_{ML}(w_i|w_{i-1}) + + 𝜆_3 P_{ML}(w_i|w_{i-2}, w_{i-1}) \)


其中 \(l_1 + l_2 + l_3 = 1\)


根據平滑公式計算,由於 \(P'(w_i|w_{i-1}) = 0.3 P(w_i) + 0.7 P(w_i | w_{i-1})\)


所以


\( P(S_1) = P(有) P'(意見|有) P'(分歧|意見) \\ = P(有)*(0.3 P(意見)+0.7P(意見|有)) * (0.3P(分歧)+0.7 P(分歧|意見)) \\ = 0.0180*(0.3*0.001+0.7*0.001)*(0.3*0.0001) \\ = 5.4*10^{-9} \)


\( P(S_2) = P(有意) P'(見|有意) P'(分歧|見) \\ = P(有意)*(0.3 P(見)+0.7P(見|有意)) * (0.3P(分歧)+0.7 P(分歧|見)) \\ = 0.0005*(0.3*0.0002)*(0.3*0.0001) \\ = 9*10^{-13} \)


\(P(S_1) > P(S_2)\) 改進一元模型,結果的區分度比較好


二元詞典


也就是 BigramDic,其中 "0START.0" "0END.0" 是虛擬的開始, 結束詞語


ex:


0START.0@歡迎     -> 「歡迎」 是開始詞
什麼@0END.0       -> 「什麼」是結束詞

二元詞表格式為 「前一個詞@後一個詞」組合出現的次數


中國@北京:100
中國@北海:1

二元詞表會有幾十萬筆,要考慮如何快速查詢


要先載入一元詞典,建置詞典樹結構,再載入二元詞典,也就是在詞典樹的結構,加掛上二元連結資訊。


N元模型


一元詞典假設兩個詞出現的機率互相獨立,但實際上不可能。


N元模型用 n 個單字組成的序列衡量切分方案的合理性


但當詞數有 20000,二元組合就有 20000^2 個,三元組合有 20000^3 個


利用馬可夫假設,解決參數空間過大的問題


馬可夫假設:一個詞的出現,僅依賴於前面出現的有限的幾個詞。


如果一個詞的出現,僅依賴於前面出現的一個詞,也就是二元模型 ex: \(P(S_1)=P(有) P(意見|有) P(分歧|意見)\)


如果一個詞的出現,僅依賴於前面出現的2個詞,就是三元模型


如果切分方案 S 由 n 個片語組成, \(P(w_1)P(w_2|w_1)P(w_3|w_2) ... P(w_n|w_{n-1})\),也就是 n 項連乘積


ex: Bigram \(P(S_1)=P(有) P(意見|有) P(分歧|意見)\)


Trigram \(P(S_1)=P(有) P(意見|有) P(分歧|有,意見)\)


因為 \(P(w_i|w_{i-1}) = freq(w_{i-1}, w_i)/freq(w_{i-1})\) 二元分詞也要使用到一元詞典


n 元機率 https://github.com/esbie/ngrams


評估語言模型


透過困惑度 perplexity 衡量語言模型。


困惑度 perplexity 是一個語言事件的不確定性的度量。


ex: 「行」後面可接 「走」「善」「不行」,所以「行」的困惑度高


有些詞的困惑度低


語言模型的困惑度要越低越好,這樣會有比較強的消除問題的能力。專業領域的語料庫,會有比較低的困惑度


困惑度的定義:


假設有一些測試資料,n個句子:\(S_1, S_2,... S_n\) 整個測試集 T 的機率為


\(log \sum_{i=1}^{n}P(S_i) = \sum_{i=1}^{n} logP(S_i)\)


困惑度為 \(2^{-x}\) 其中 \(x=\frac{1}{W} \sum_{i=1}^{n} logP(S_i)\) , W 是測試集 T 的總詞數


假設詞表 V,其中有 N 個詞。 \(P(w)=1/N\) 困惑度為 \(2^{-x}\) ,其中 \(x=log(1/N)\) ,所以困惑度為 N


ex:


訓練集有 38000 萬個詞,詞表有 19979 個詞,測試集有 150萬個詞。一元模型的困惑度 = 962


二元模型困惑度 = 170,三元模型困惑度 = 109


平滑演算法


語料有限,不可能覆蓋所有詞彙,當 N 元模型,N很大時,由於樣本數量有限,導致先驗機率值為 0,這就是 零機率問題。


當 N=1 一元模型,也存在零機率問題。例如有些詞在詞表中,但沒有出現在語料庫。


回歸分析可用來預測沒有測量過的值。


平滑演算法就是用觀測到的事件,預測未觀測事件的機率。


資料稀疏在統計自然語言處理中表現的就是零機率問題。有各種平滑演算法可解決此問題


最簡單的是加法平滑演算法。原理是替每個專案增加 \(lambda\) ( 其中 \(1>=lambda>=0\)) ,然後除以總數,作為專案新的機率。因數學家 Laplace 首先提出用加 1 的方法,估計沒有出現過的現象的機率,所以加法平滑也稱為 Laplace平滑


因不容易決定 lambda 的值。另一種 Good-Turning 方法不需要 lambda


假設詞典有 x 個詞,在語料庫出現 r 次的詞有 \(N_r\) 個,例如出現一次有 \(N_1\) 個


語料庫總詞數 \(N=0*N_0 + 1*N_1 + ... + r*N_r\) 其中 \(x=N_0+N_1+.. +N_r\)


使用觀察到的類別 r+1 的全部機率,估計類別 r 的全部機率。


沒有出現過的詞的總機率 \(p_0 = N_1/N\) 分攤到每個詞的機率為 \(N_1/(N*N_0)\)


第二步是估計語料庫中,出現過一次的總機率為 \(p_1 = 2N_2/N\) 分攤到每個詞的機率為 \(N_2/(N*N_1)\)


當 r 很大, \(N_r\) 可能為 0,此時不再求平滑


對條件機率的 N 元估計平滑


\(P_{GT}(w_i|w_1,...,w_{i-1}) = \frac{c^*(w_1,...,w_i)}{c^*(w_1,...,w_{i-1})}\)


其中 \(c^*\) 就是 GT 估計


估計三元條件機率為 \(P_{GT}(w_3|w_1,w_2) = \frac{c^*(w_1,w_2,w_3)}{c^*(w_1,w_2)}\)


對沒出現詞語的三元聯合機率為


\(P_{GT}(w_1,w_2,w_3) = C_0^*/N = N_1/(N_0*N)\)


KenLM 語言模型工具


github: https://github.com/kpu/kenlm.git


python module: pip install https://github.com/kpu/kenlm/archive/master.zip


測試語言模型檔案 test.arpa


使用 test.arpa 評估句子的機率


import kenlm
model = kenlm.Model('lm/test.arpa')
print(model.score('this is a sentence .', bos = True, eos = True))

#輸出
-49.57345703125

kenlm 編譯後可使用修改的 Kerser-Ney 平滑法從輸入文字 test.arpa 估計語言模型


$bin/lmplz -o 5 <test > text.arpa

建立三元模型


./lmplz --order 3 --text input.txt.tok --arpa output.arpa

ARPA 檔案格式


n-gram 語言模型格式


<LM_definition> = [ { <comment> } ]
                  \data\
                  <header>
                  <body>
                  \end\
   <comment> = { <word> }

<header> = { ngram <int>=<int> }

其中 第一個 列出 n-gram 階數,第二個 列出 n-gram 項目的數量


<body>  = { <lmpart1> } <lmpart2>
<lmpart1> = \<int>-grams:
            { <ngramdef1> }
<lmpart2> = \<int>-grams:
            { <ngramdef2> }
<ngramdef1> = <float> { <word> }  <float>
<ngramdef2> = <float> { <word> }

bigram 語言模型由 unigram 與 bigram 兩個部分組成。


實際機率用對數取代,所以會看到負數


sample:


wood pittsburgh cindy jean
jean wood

共四個單字,加上 句子開始 <s>、結束 </s>、未知單字 <unk> ,共七個


語言模型:


\data\
ngram 1=7
ngram 2=7

\1-grams:
-1.0000     <unk>               -0.2553
-98.9366    <s>                 -0.3064
-1.0000     </s>                0.0000
-0.6990     wood                -0.2553
-0.6990     cindy               -0.2553
-0.6990     pittsburgh  -0.2553
-0.6990     jean                -0.1973

\2-grams:
-0.2553     <unk> wood
-0.2553     <s> <unk>
-0.2553     wood pittsburgh
-0.2553     cindy jean
-0.2553     pittsburgh cindy
-0.5563     jean </s>
-0.5563     jean wood

\end\

依存語言模型


可建立單字之間的句法相依關係模型。


詞之間的關係有方向性。大多數的語言都滿足投射性,也就是如果 詞 p 依存於 詞 q,那麼 p 和 q 之間的任意詞 r 就不能依存到 p 和 q 組成的跨度之外。


箭頭的起點是從屬詞(修飾詞),終點指向支配詞(核心詞),弧上標記是依存關係標記。


一:從屬詞,本:支配詞,"qc" 是依存關係標記


依存文法也可以表示成樹狀結構


機率計算公式: T: 依存樹拓樸關係


\( P(s|T) = P(the|boy) P(boy|find) P(will|find) P(find|<NONE>) P(it|find) P(interesting|find) \)


References


Tutorials


語音識別的技術原理是什麼?


初識語音識別及 Kaldi 的安裝使用


​ The CMU Pronouncing Dictionary.


  • 聲學模型:是將聲學和發音學(phonetics)的知識進行整合,以特徵提取部分生成的特徵作為輸入,並為可變長特徵序列生成聲學模型分數。
  • 語言模型:通過從訓練語料(通常是文本形式)學習詞之間的相互關係,來估計假設詞序列的可能性,又叫語言模型分數。
  • GMM:Gaussian Mixture Model, 高斯混合模型,描述基於傅里葉頻譜語音特徵的統計模型,用於傳統聲學模型的建模中。
  • HMM:Hidden Markov Model, 隱馬爾科夫模型,是一種用來描述含有隱含未知參數的馬爾科夫過程,其難點是從可觀察的參數中確定該過程的隱含參數。然後利用這些參數來作進一步的分析,例如模式識別。
  • MFCC:Mel-Frequency Cepstral Coefficients, 梅爾頻率倒譜係數,是組成梅爾頻率倒譜的係數。衍生自音訊片段的倒頻譜(cepstrum)。倒譜與梅爾頻率倒譜的區別在於,梅爾頻率倒譜的頻帶劃分是在梅爾刻度上等距劃分的,它比用於正常的對數倒頻譜中的線性間隔的頻帶更接近人類的聽覺系統。廣泛應用於語音識別中。
  • Fbank:Mel Frequency Filter Bank, 梅爾頻率濾波器組。
  • WER:Word Error Rate, 詞錯誤率,是最常見的衡量語音識別系統性能的指標。


  • 特徵提取:語音識別第一步就是特徵提取,去除掉語音信號中對於語音識別無用的冗餘信息(如背景噪音),保留能夠反映語音本質特徵的信息(為後面的聲學模型提取合適的特徵向量),並用一定的形式表示出來;較常用的特徵提取算法有 MFCC。
  • 聲學模型訓練:根據語音庫的特徵參數訓練出聲學模型參數,在識別的時候可以將待識別的語音的特徵參數同聲學模型進行匹配,從而得到識別結果。目前主流的語音識別系統多採用 HMM 進行聲學模型建模。
  • 語言模型訓練:就是用來計算一個句子出現的概率模型,主要用於決定哪個詞序列的可能性更大。語言模型分為三個層次:字典知識、語法知識、句法知識。對訓練文本庫進行語法、語義分析,經過基於統計模型訓練得到語言模型。
  • 語音解碼與搜索算法:其中解碼器就是針對輸入的語音信號,根據已經訓練好的聲學模型、語言模型以及字典建立一個識別網絡,再根據搜索算法在該網絡中尋找一條最佳路徑,使得能夠以最大概率輸出該語音信號的詞串,這樣就確定這個語音樣本的文字。

語音識別工具包Kaldi的學習和使用(三):數據集的訓練和使用


語音識別大牛 Daniel Povey 莫名被JHU開除後,怒拒Facebook,轉向中國公司與高校


頂級語音專家、MSR首席研究員俞棟:語音識別的四大前沿研究


中文是一個有音調的語言,音調對字和詞的識別是有影響的。音調信息如果用好的話,就有可能提升識別率。不過大家發現 deep learning 模型有很強的非線性映射功能,很多音調裡的信息可以被模型自動學到,不需要特別處理。


很多研究組都發現或證實使用小 Kernel 的 Deep CNN 比我們之前在書裡面提到的使用大 kernel 的 CNN 方法效果更好。Deep CNN 跟 LSTM 比有一個好處。用 LSTM 的話,一般你需要用雙向的 LSTM 效果才比較好。但是雙向 LSTM 會引入很長的時延,因為必須要在整個句子說完之後,識別才能開始。而 Deep CNN 的時延相對短很多,所以在實時系統裡面我們會更傾向於用 Deep CNN 而不是雙向 LSTM。


kaldi中文語音識別(1)


System architecture of the cloud-based HALEF spoken dialog system depicting the various modular open-source components


Kaldi 是一個非常強大的語音識別工具庫,最近有些業者用 kaldi nnet3 語音辨識工具進行 TDNN 訓練,用於機器人電話客服。


語音識別從入門到放棄


語音變成文字的大致流程為:將一段語音的聲波按幀切開,用幀組成狀態,用狀態組成音素,再將音素合成單詞,語音就變成了文字 。


語音識別kaldi該如何學習?


學習kaldi的話,先從hmm-gmm入手比較好,像steps/traindelta.sh, steps/trainfmllr.sh, steps/decode.sh這些腳本都是基於hmm-gmm模型。


搞清楚hmm-gmm之後對語音識別就有了一個清晰的理解,接下來就可以上手神經網絡。kaldi支持很多神經網路,如MLP, RNN, CNN, LSTM,如果對神經網路瞭解不多還是從MLP入手較好,MLP是神經網路中最基礎的模型。


台灣言語工具 語音辨識


語音識別技術的前世今生


語音識別技術的前世今生之前世


u010384318的專欄 機器學習 語音識別 ing


語音識別——基於深度學習的中文語音識別系統實現(代碼詳解)


book


李理的博客


深度學習理論與實戰:提高篇


微軟Edx語音識別課程


基於WFST的語音識別解碼器


Kaldi的MFCC特徵提取代碼分析


GitHub projects


zzw922cn/AutomaticSpeechRecognition


​ End-to-end Automatic Speech Recognition for Madarian and English in Tensorflow


audier DeepSpeechRecognition


​ A Chinese Deep Speech Recognition System 包括基於深度學習的聲學模型和基於深度學習的語言模型


​ 基於深度學習的中文語音識別系統


libai2 masr


​ 中文語音識別,高識別率預訓練模型,支持docker快速安裝 Chinese Speech Recognition; Mandarin Automatic Speech Recognition;


​ deepxuexi/ARFASR


​ An very convenient Audio Recorder For ASR Projects. It can recording 16K 16Bit Wav files for ASR projects for the next recognizing. it use directsound for recording in Windows OS , Python3.6 . Press Enter to start recording , and press Enter again to stop recording as you think it's recording enough. Press 'q' to exit the process.

2020/1/20

CTF Steganography 語音資料隱寫

CTF(Capture The Flag)奪旗賽,在網絡安全領域中指的是網絡安全技術人員之間進行技術競技的一種比賽形式。其中有一項 STEGA(Steganography 隱寫),題目的Flag會隱藏到圖片、語音、視訊等各類數位化資料中,透過一些工具與技術,取得隱藏在其中的 flag。


HelloKittyKitty.wav


這個網頁 Nuit du Hack CTF Qualifications: Here, kitty kitty! 裡面有個 HelloKittyKitty.wav,直接聽就是一段喵喵的音樂,但是如果用 Adudacity 或是 Praat 打開,可看到語音檔有兩個聲道,其中左聲道有一些看起來不像語音的資料。


這些是 morse code,將長短符號記錄下來是


..... -... -.-. ----. ..--- ..... -.... ....- ----. -.-. -... ----- .---- ---.. ---.. ..-. ..... ..--- . -.... .---- --... -.. --... ----- ----. ..--- ----. .---- ----. .---- -.-.

送到 online morse code decoder 解碼可得到 5BC925649CB0188F52E617D70929191C


看起來很像是 md5 string,用 md5 decoder (md5應該是無法解密的,但網站用一個很大的 DB 把很多 string 的 md5 結果記錄起來查詢) 反查可得到 valar dohaeris


Here with your eyes


這個連結有一個 sound.wav,直接聽像是鳥叫聲,用 Adudacity 打開,看起來也跟一般聲音檔差不多。但如果將聲音檔改成頻譜圖的顯示,畫面上可直接看到這樣的字串。


flag: e5353bb7b57578bd4da1c898a8e2d767


dtmf


這個 dial.wav 聽起來,就像是撥打電話數字鍵盤的 dtmf tone 語音,用 dtmf decoder 可解出


4*7# 2*6# 1*2# 2*5# 2*3# 3*6# 2*6# 2*6# 3*6# 2*5# 3*4# 1*2

4*7 就是 T9 鍵盤的 7 按四次,可得到 s,依此類推


s  n  a  k  e  o  n  n  o  k  i  a


godwave.wav


ref: JarvisOJ Misc 部分題解


JarvisOJ Misc 上帝之音


[misc]上帝之音 400


godwave.wav 用 Audacity 打開來看,是個 mono, 10000000 Hz 的 wav,放大來看,是以振幅儲存類似 on-off keying OOK 的編碼


先以程式讀取 wav,由列印結果發現,大約每 64 個資料點做區隔,可用這些資料點的總和區分 0 or 1,再來列印結果,知道資料只有 01 10 兩種,符合 Manchaster 編碼的特性。


#!/usr/bin/env python3
# -*- coding: utf-8 -*-
import wave
import matplotlib.pyplot as plt
import numpy as np

def read_wav_data(filename):
  wav = wave.open(filename,"rb") # 打開一個wav格式的聲音文件流
  frame = wav.getnframes() # 獲取幀數
  channel=wav.getnchannels() # 獲取聲道數
  framerate=wav.getframerate() # 獲取幀速率
  sample_width=wav.getsampwidth() # 獲取實例的比特寬度,即每一幀的字節數

  print("frame=%i, channel=%i, framerate=%i, sample_width=%i" %(frame, channel, framerate, sample_width))

  str_data = wav.readframes(frame) # 讀取全部的幀
  wav.close() # 關閉流
  wave_data = np.fromstring(str_data, dtype = np.int16) # 將聲音文件數據轉換為數組矩陣形式
  wave_data.shape = -1, channel # 按照聲道數將數組整形,單聲道時候是一列數組,雙聲道時候是兩列的矩陣
  wave_data = wave_data.T # 將矩陣轉置
  wave_data = wave_data
  return wave_data, frame, framerate

def wav_show(wave_data, fs): # 顯示出來聲音波形
  time = np.arange(0, len(wave_data)) * (1.0/fs)  # 計算聲音的播放時間,單位為秒
  # 畫聲音波形
  plt.plot(time, wave_data)
  plt.show()

if(__name__=='__main__'):
  # frame=1735680, channel=1, framerate=10000000, sample_width=2
  wave_data, frame, framerate = read_wav_data("godwave.wav")
  # wav_show(wave_data[0],fs)
  # wav_show(wave_data[1],fs)  # 如果是雙聲道則保留這一行,否則刪掉這一行

  # for i in range(300):
  #   print( "{index} = {val}".format(index = (i+1), val = abs(wave_data[0][i])) )
  # 由列印結果發現,大約每 64 個資料點做區隔,可用這些資料點的總和區分 0 or 1

  string = ''
  norm = 0
  for i in range(frame):
    norm = norm+abs(wave_data[0][i])
    if (i+1) % 64 == 0:
      # print("norm={norm}".format(norm=norm))
# norm=1244430
# norm=25330
# norm=32868
# norm=1118668
      if norm > 100000:
          string += '1'
      else:
          string += '0'
      # 用這個方式觀察,知道資料只有 01 10 兩種,符合 Manchaster 編碼的特性
      # if (i+1) % (128*8) == 0:
      #     string += "\n"
      norm = 0
  with open('output.txt','w') as output:
    output.writelines(string)

# -*- coding: utf-8 -*-
with open('output.txt', 'r') as f:
    data = f.readline()
    # print len(data)
    count = 0
    res = 0
    ans = b''
    key = ""

    pactemp = ""

    while data != '':
        pac = data[:2]
        data = data[2:]
        pactemp = pactemp + pac
        # print("pac={pac}".format(pac=pac))
        if pac != '':
            if pac[0] == '0' and pac[1] == '1':
                # print("res={res}".format(res=res))
                res = (res<<1)|0
                count = count + 1
            if pac[0] == '1' and pac[1] == '0':
                # print("res={res}".format(res=res))
                res = (res<<1)|1
                count = count + 1
            if count == 8:
                # print("pactemp={pactemp}, res={res}".format(pactemp=pactemp, res=res))
                ans += res.to_bytes(1, byteorder='big', signed=False)
                # ans += bytes(res)
                count = 0
                res = 0

                pactemp = ""
                pac = ""
        else:
            break

# print("ans={ans}".format(ans=ans))

with open('out.png', 'wb') as f2:
    f2.write(ans)

Manchaster解碼 結果是一張 png 圖。打開後是一張 QR code 圖片,放到 qr code decoder 後取得結果:


Raw text PCTF{Good_Signal_Analyzer}
Raw bytes 41 a5 04 35 44 67 b4 76 f6 f6 45 f5 36 96 76 e6 16 c5 f4 16 e6 16 c7 97 a6 57 27 d0 ec 11 ec 11 ec 11 ec 11
Barcode format QR_CODE
Parsed Result Type TEXT
Parsed Result PCTF{Good_Signal_Analyzer}

godwavefsk.wav


godwavefsk.wav 用 Audacity 打開來看,是個 mono, 10000000 Hz 的 wav,放大來看,是以頻率儲存類似 on-off keying OOK 的編碼


根據上一個點的資料,判斷是不是由負數變成正數,計算改變的次數,如果改變的次數超過 8 次,就表示這是頻率比較大的區段


#!/usr/bin/env python3
# -*- coding: utf-8 -*-
import wave
import matplotlib.pyplot as plt
import numpy as np

def read_wav_data(filename):
  wav = wave.open(filename,"rb") # 打開一個wav格式的聲音文件流
  frame = wav.getnframes() # 獲取幀數
  channel=wav.getnchannels() # 獲取聲道數
  framerate=wav.getframerate() # 獲取幀速率
  sample_width=wav.getsampwidth() # 獲取實例的比特寬度,即每一幀的字節數

  print("frame=%i, channel=%i, framerate=%i, sample_width=%i" %(frame, channel, framerate, sample_width))

  str_data = wav.readframes(frame) # 讀取全部的幀
  wav.close() # 關閉流
  wave_data = np.fromstring(str_data, dtype = np.int16) # 將聲音文件數據轉換為數組矩陣形式
  wave_data.shape = -1, channel # 按照聲道數將數組整形,單聲道時候是一列數組,雙聲道時候是兩列的矩陣
  wave_data = wave_data.T # 將矩陣轉置
  wave_data = wave_data
  return wave_data, frame, framerate

def wav_show(wave_data, fs): # 顯示出來聲音波形
  time = np.arange(0, len(wave_data)) * (1.0/fs)  # 計算聲音的播放時間,單位為秒
  # 畫聲音波形
  plt.plot(time, wave_data)
  plt.show()

if(__name__=='__main__'):
  # frame=1988608, channel=1, framerate=10000000, sample_width=2
  wave_data, frame, framerate = read_wav_data("godwavefsk.wav")
  # wav_show(wave_data[0],fs)
  # wav_show(wave_data[1],fs)  # 如果是雙聲道則保留這一行,否則刪掉這一行

  # for i in range(300):
  #   print( "{index} = {val}".format(index = (i+1), val = wave_data[0][i]) )

  string = ''
  old_wave_data = 0
  count = 0
  for i in range(frame):
    # 根據上一個點的資料,判斷是不是由負數變成正數,計算改變的次數,如果改變的次數超過 8 次,就表示這是頻率比較大的區段
    if( old_wave_data < 0 and wave_data[0][i]>0 ):
      # print("old_wave_data={old_wave_data}, wave_data[0][i]={new_wave_data}".format(old_wave_data=old_wave_data, new_wave_data=wave_data[0][i]))
      count = count + 1
    old_wave_data = wave_data[0][i]
    if (i+1) % 64 == 0:
      # print("count={count}".format(count=count))
      if count > 8:
          string += '1'
      else:
          string += '0'
      # 用這個方式觀察,知道資料只有 01 10 兩種,符合 Manchaster 編碼的特性
      # if (i+1) % (128*8) == 0:
      #     string += "\n"
      count = 0
  with open('output.txt','w') as output:
    output.writelines(string)

用上一個例子中將 output.txt 的 Manchaster 解碼程式,輸出 png,可看到是一個 QR code。


Raw text CTF{Nice_FSK_D3ModUl47o2}
Raw bytes 41 94 35 44 67 b4 e6 96 36 55 f4 65 34 b5 f4 43 34 d6 f6 45 56 c3 43 76 f3 27 d0 ec 11 ec 11 ec 11 ec 11 ec
Barcode format QR_CODE
Parsed Result Type TEXT
Parsed Result CTF{Nice_FSK_D3ModUl47o2}

References


CTF學習規劃————1、如何入門CTF


關於ctf競賽訓練 積累的資料


ctf-stego彙總


CTF中音頻隱寫的一些整理總結


音頻隱寫


資料隱藏技術揭祕筆記

2020/1/13

DeepLearning常見名詞

Deep Learning 神經網路模型的發展大約歷經四個時期:


  1. 1950~1960 基本的感知器,目前公認鼻祖是 1957 年提出 Perceptron 演算法的 Rosenblatt
  2. 1970~1980 發現 multilayer perceptron 多層感知器,有高度非線性函數的能力,甚至有神經網路能解決所有問題的論點
  3. 1990~2000 傳統神經網路沈寂,kernel 方法大行其道,主因是機器運算能力不足,資料量太大,網際網路尚未普及。
  4. 2006年以後,有些技術進步,促成深度學習的神經網路模型的大量應用。廉價平行計算 GPU 出現,網際網路普及,更容易取得大規模的資料。

通常深度學習適合處理資料量大、具備某些資料規則,但決策函數高度非線性的問題。例如圖形辨識、語音辨識、文字產生、自然語言分析、手寫數字辨識等等。


神經網路的四類函數


  1. 組合函數 combination function
    輸入層後面的網路中,每一個神經元的功能都是將上一層產生的向量,透過本身的函數產生一個標量值,此標量就是下一個神經元輸入變數。這種在網路中間,將向量映射為標量的函數,就稱為組合函數。常見的組合函數包含線性組合函數與基於歐幾里德距離的函數。

  2. 啟動函數 activation function
    大部分的神經元都將一維向量的網路輸入變數,透過某個函數映射為另一個一維向量的數值,這個函數稱為啟動函數,產生的值就稱為啟動狀態。


    除了輸出層以外,啟動狀態的值透過神經的連結,輸入到下一層的一個或多個神經元中。因啟動函數通常是將一個實數域的值映射到有限域,也稱為塌陷函數。


    ex: tanh, logistic 都是將實數域映射到 (-1,1) 或 (0,1) 之間


    啟動函數的主要作用是給隱含層引入非線性。一個只有線性關係隱含層的多層神經網路,不會比一般只包含輸入層與輸出層的兩層神經網路更強大。但加入非線性後,多層神經網路的預測能力就提高很多。


    對反向傳播演算法來說,啟動函數必須可微分,如果該函數是在有限域,效果更好,例如 logistic, tanh, 高斯函數,這些函數又稱為 sigmoid 函數。tanh, arctan 這種包含正負值域的函數,通常收斂速度較快,這是因為 conditioning number 更好。


    隱藏層的啟動函數歷經 sigmoid 到 threshold 的轉變,反映了 deep learning 技術和理論的發展。


    早期認為sigmoid 比 threhold 函數好,因為 threshold 函數的誤差函數是 stepwise constant,一階導數為不存在或是 0,導致無法進行有效的反向傳播演算法計算。sigmoid 是連續可微分的函數,參數一點變化,就會帶來輸出的變化,有助於判斷參數變動是否有利於最終函數的最佳化。而 threshold 的參數微小變化,不影響輸出,所以演算法收斂速度較慢。


    但 1991年 Sepp Hochreiter 發現,sigmoid 有 gradient vanishing 的問題。梯度消失就是梯度(誤差的訊號)隨著隱藏層數的增加,會指數減少。因反向傳播演算法的梯度計算採用鏈式法則,第 n 層需要乘以前面各層的梯度,但由於 sigmoid 的值域在 (-1,1) 或 (0,1) 之間,很多個很小的數相乘後,第n層的梯度就會趨近於 0,造成模型訓練的問題。而 threshold 啟動函數的值域不是 (-1,1),因此沒有這個問題,ex: reLU 的值域是 (0, +inf)。


    另外 Hard Max 這個 threshold 啟動函數: max(0,x) 可在隱藏層加入稀疏性 sparsity,有助於模型的訓練。


    對於輸出層,應該盡量選擇適合變數分佈的啟動函數


    • 對只有 0, 1 取值的雙值因變數,可使用 logistic 函數
    • 對有多個取值的離散因變數,例如 0~9 數字辨識,可使用 softmax (logistic 的自然衍生函數)
    • 對有限值域的連續因變數,可使用 logistic 或 tanh 啟動函數,但需要將因變數的值域伸縮到 logistic/tanh 對應的值域中
    • 如果因變數取值為正,但沒有上限,可使用指數函數
    • 如果因變數沒有有限值域,或雖是有限值域但邊界未知,可使用線性函數

    輸出層的啟動函數,選擇方法跟統計學模型的應用類似,就是統計學廣義線性模型的連結函數 link function 功能。

  3. 誤差函數 error function
    監督學習的神經網路都需要一個函數,量測模型輸出值 p 跟真實因變數值 y 的差異,一般稱為誤差。但這個值不能直接用來衡量模型的品質。


    如果有一個完美的模型,其誤差為 0,但一般誤差為偏離0 的絕對值。誤差越趨近 0 越好。誤差函數也稱為損失函數 loss function。


    常用的 loss function:


    • 均方誤差(MSE):\( \frac{1}{n} \sum_{i=1}^{n} ( y^{(i)} - f_𝜃(x^{(i)} ) )^2 \)
      通常用在實數值域連續變數的迴歸問題,對於誤差較大的情況給予更多權重。

    • 平均絕對誤差(MAE):\( \frac{1}{n} \sum_{i=1}^{n} | y^{(i)} - p^{i} | \)
      應用在迴歸問題,或是時間序列預測問題。每個誤差對總體誤差的貢獻,與其誤差的絕對值成線性比例,MSE 沒有這個特性。

    • 交叉熵損失(cross entropy):也稱為對數損失函數,是針對分類模型的效能比較,依照分類模型是二分類或是多分類,還可分為二分類交叉熵與多分類交叉熵兩種。
      \( \sum_{c=1}^{C} \sum_{i=1}^{N} -y_{c,i} log_2(p_{c,i}) \)


      C是類別數,N 是所有的資料數。\( y_{c,i} \) 是binary indicator (0 or 1) from one hot encode (第i筆資料屬於第c類真實類別)。\( p_{c,i} \)是第i筆資料屬於第c類預測出來的機率。


      cross-entropy 就是映射到最可能類別機率的對數,當預測值的分佈跟實際因變數的分佈一致時,交叉熵最小。

  4. 目標函數 object function
    在訓練階段直接最小化的函數。神經網路的訓練結果,是在最小化訓練資料的預測值與真實值的誤差。結果可能會發生 overfitting 的狀況。例如模型在訓練資料上表現很好,但在測試資料或真實應用時,表現較差。也就是模型普適化不好。


    一般會用正規化,減少 overfitting 的狀況。這時目標函數為誤差函數與正規函數的和。例如採用 weight decay 方法時,正規函數是權重的平方和,這跟一般 ridge regression 的技巧一樣。如果使用貝氏定理,也可以將權重先驗分佈的對數,作為正則項。如果不使用正則項,目標函數就和總體或平均誤差函數一樣。


批量 Batch


有兩種


  1. 對應到模型訓練方法,就是將所有資料處理完後,一次性更新權重或參數的估計值

  2. 對應到模型訓練中的資料,是指一次輸入模型計算的資料量


批量概念的模型訓練,一般是以下步驟:


  1. 初始化參數
  2. 重複以下步驟
    2.1 處理所有資料
    2.2 更新參數

遞增演算法的步驟


  1. 初始化參數
  2. 重複以下步驟
    2.1 處理一個或一組資料點
    2.2 更新參數

差別是批量演算法一次處理所有資料,遞增演算法,處理一或多個資料,就要更新一次參數。


反向傳播演算法中,「處理」 就是計算損失函數的梯度變化曲線。
批量驗算法中,「處理」 是計算平均或總體損失函數的梯度變化曲線
遞增演算法中,損失函數僅計算對應於該觀測值或數個觀測值的梯度變化曲線。


「更新」 是從既有的參數值,減去梯度變化率和學習速率的乘積。


online/offline learning


online learning 的觀測值,處理後就會被丟棄,同時更新參數。永遠是一種遞增演算法。


offline learning 的資料可重複取得,有以下優點


  1. 對任何固定個數的參數,可直接計算出目標函數,很容易驗證模型訓練是否往所需方向前進
  2. 計算精度可達到任意合理的程度
  3. 可使用各種不同的演算法,避免局部最佳化的情況
  4. 可採用訓練、驗證、測試三分法,針對模型的普適化進行驗證
  5. 可計算預測值及其信賴區間

online learning 不儲存資料,無法重複取得資料,因此無法在訓練集上計算 loss function,無法在驗證集上計算誤差。所以online learning 演算法比較不穩定。


bias 偏移值


通常在計算網路輸入時,會加入一個 bias 偏移值。如果是線性輸出神經元,bias 就是線性迴歸中的截距。


跟截距的作用類似,bias 視為一個由特殊神經元引出的連結權重,這是因為它通常連結到一個固定單位值的偏移神經元。例如在多層感知器 MLP 神經網路中,某一個神經元的輸入參數為 N 維,這個神經元在高維空間根據參數畫出一個超平面,一邊是正值,一邊是負值。參數決定了超平面在輸入空間的相對位置,如果沒有 bias,超平面就需要通過原點,這就限制了平面的位置。


每個隱藏層和輸出層的神經元都有自己的 bias,但如果輸入資料已經等比例轉換到一個有限值域,例如 [0,1]區間,那麼第一個隱藏層的神經元設定 bias 後,後面任何層內跟這個神經原有連結的其他神經元,就不需要再設定 bias 了。


標準化資料


有三種常見的標準化


  1. rescaling
    加上一個向量,或減去一個常數,再乘上或除以一個常數。例如將華氏溫度轉換為攝氏溫度。

  2. normalization
    將一個向量除以其範數,例如採用歐幾里得距離,則使用向量的變異量數作為範數來正規化向量。deep learning 通常用全距作為範數,也就是向量減去最小值,然後除以全距,可讓數值落於 0~1 之間

  3. standardization
    將一個向量移除其位置與規模的度量。例如遵循常態分佈的向量,可減去平均值,除以變異數,來標準化資料。可得到一個遵守標準常態分佈的向量。


在 deep learning 要視情況決定要不要做標準化,一般來說,如果啟動函數的值域在 0~1 之間,那麼正規化資料到 [0,1] 比較合理,另外正規化資料,能讓計算過程穩定,特別是資料值域範圍有較大差別的時候。


梯度下降演算法


最佳化決策函數時,通常是針對一個誤差的度量(例如誤差的平方),求得一系列參數,然後最小化這個誤差度量的值來進行。目前一般採用 gradient descent method 梯度下降演算法。


該方法類似遊客在不知名的高山要儘快安全到達谷底,他必須在東西、南北兩個軸向進行選擇,以確保下山路徑又快又安全。如果把軸向想成目標函數的兩個維度,那麼該怎麼取得最佳路徑呢?


因為在山頂不知道路況,有可能因為初始化參數不佳,造成只能得到局部最佳解的狀況。梯度下降法是一種短是的方法,只靠一個傾斜角,看那個方向比較陡,就往該方向下滑一段距離。


通常會用隨機梯度下降法 stochastic gradient descent,這是針對每個觀測值執行梯度下降的最佳化演算,原本的方法稱為 batch 或 offline 演算法,新的方法稱為 incremental 或 online 演算法,因為參數估計值會隨著觀測值的變化而更新。


目前常見是使用一階導函數的梯度下降法,也有基於二階導函數的演算法,稱為牛頓法。這種方法相當於遊客帶了一個高度計,滑下去後,就可查閱結果,如果比原來高,就退回原來的地方,重新跳一小步。


假設有一個函數 f 有兩個變數 \(x_0, x_1\) ,則 f 的梯度法就是


\( x_0' = x_0 - 𝜂 \frac{𝜕f}{𝜕x_0} \)


\( x_1' = x_1 - 𝜂 \frac{𝜕f}{𝜕x_1} \)


其中 𝜂 是學習率,就是一次學習中,要往前增加多少步進值,在訓練前,要先決定 𝜂 是 0.1 或 0.001 或某一個數值,這個值太大,可能會發生找不到最佳解的狀況,太小,則會發生學習速度太慢 (loss rate 下降太慢)的狀況。


因此 𝜂 學習率這種參數稱為 hyperparameter,這跟 weight 權重、bias 不同,這是一個根據經驗設定與調整出來的一個人工設定的參數。


誤差反向傳播演算法


如果神經網路只有一層,只要反覆運用這個方法到 loss function,就可依照公式更新參數,直到收斂就好了。權重參數的 loss function 梯度,可以根據數值微分計算而來。微分的計算很簡單,但計算量大比較花時間。


但如果輸入層跟輸出層之間,有很多隱含層,就需要一個高效率的演算法,減少計算量。為了快速估計深度神經網路的權重值,backpropagation 就是這種演算法,可有效率地計算微分。以 computational graph 來理解這個演算法。


ref: Computational Graph


ref: DL3-Computational Graph & Backpropagation


ref: computational graph 李弘毅


node: 代表 variable (scalar, vector, tensor)


edge: 代表 operation (function)


\( y=f(g(h(x))) \) 可拆解為三個合成函數 \( u=h(x), v=g(u), y=f(v) \)


如果某個節點有兩個 input,可寫成 \( a=f(b,c) \),就是 b,c 兩個 node 都指向 a


這是 Computational Graph 的一個例子,要由下往上看


因為 computational graph 的概念就是合成函數,而合成函數在計算微分,可以用 chain rule。


case 1 的 \( \frac{dz}{dx} = \frac{dz}{dy}*\frac{dy}{dx} \) note: \( z=h(y) z=h(g(x)) \)


根據 \( \frac{𝜕e}{𝜕b}\) 的公式,\(c=a+b, d=b+1, e=c*d\),利用 computational graph,由下往上,計算每一個箭頭的偏微分,在合併用在原本的公式中


舉例 a=3, b=2,套用在剛剛的計算過程中


如果由 b=1 開始,往上計算可得到 \( \frac{𝜕e}{𝜕b}=8\) 。 可發現跟剛剛一樣,有用到 \( \frac{𝜕e}{𝜕c}=3, \frac{𝜕e}{𝜕d}=5, \frac{𝜕c}{𝜕a}=1, \frac{𝜕c}{𝜕b}=1, \frac{𝜕d}{𝜕b}=1\) 這些偏微分的結果


如果由 a=1 開始,往上計算可得到 \( \frac{𝜕e}{𝜕a}=3\) \( \frac{𝜕e}{𝜕b}=8\) ,跟剛剛一樣,有用到 \( \frac{𝜕e}{𝜕c}=3, \frac{𝜕e}{𝜕d}=5, \frac{𝜕c}{𝜕a}=1, \frac{𝜕c}{𝜕b}=1, \frac{𝜕d}{𝜕b}=1\) 這些偏微分的結果


\(c=a+b, d=b+1, e=c*d\),一樣使用 跟剛剛一樣,有用到 \( \frac{𝜕e}{𝜕c}=3, \frac{𝜕e}{𝜕d}=5, \frac{𝜕c}{𝜕a}=1, \frac{𝜕c}{𝜕b}=1, \frac{𝜕d}{𝜕b}=1\) 這些偏微分的結果, 反方向填寫,得到 \( \frac{𝜕e}{𝜕a}=3, \frac{𝜕e}{𝜕b}=8\)


ref: https://web.cs.hacettepe.edu.tr/~aykut/classes/spring2016/bbm406/slides/l12-backpropagation.pdf


首先有一個合成函數 \(f(x,y,z)\),當 \( x=-2, y=5, z=-4 \) 時,我們想要得到 \( \frac{𝜕f}{𝜕x}, \frac{𝜕f}{𝜕y}, \frac{𝜕f}{𝜕z} \) 的結果。一開始,就先用 computational graph 描述題目


在最右邊,寫上 \(\frac{𝜕f}{𝜕f}=1\)


因為 \( f=qz \),而 \( \frac{𝜕f}{𝜕z} = q\),因此就等於 3


因為 \( f=qz \),而 \( \frac{𝜕f}{𝜕q} = z\),因此就等於 -4


因為 \( q=x+y \),而 \( \frac{𝜕f}{𝜕y} = \frac{𝜕f}{𝜕q} \frac{𝜕q}{𝜕y} = -4 * 1 = -4 \),因此就等於 -4


因為 \( q=x+y \),而 \( \frac{𝜕f}{𝜕x} = \frac{𝜕f}{𝜕q} \frac{𝜕q}{𝜕x} = -4 * 1 = -4 \),因此就等於 -4


References


python 深度學習實作 keras 快速上手


深度學習:使用激勵函數的目的、如何選擇激勵函數 Deep Learning : the role of the activation function


生物神經元的工作原理對深度學習神經元的啟發


deep learning 用python進行深度學習的基礎理論實作

2020/1/6

Google Voice Kit v1

根據這兩個網址的說明,安裝 Google Voice Kit V1


Google Voice Kit V1


一口氣將 Voice Kit 連上 Google Cloud Platform — 實作篇


note: 注意變壓器必須要輸出 5V 2.5A,電流不夠會讓 RPi 一直 reboot


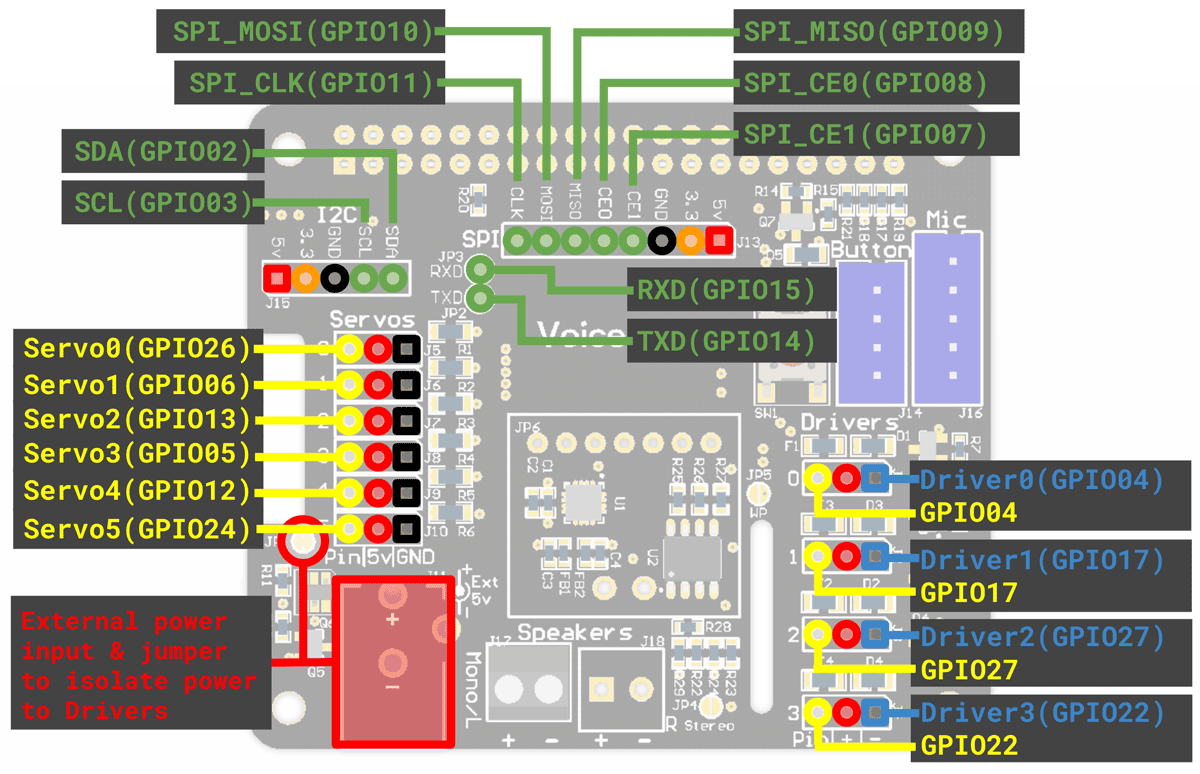
Voice HAT (Hardware Attached on Top)


GPIO pins used by Voice HAT


傳感器常用的 I2C, UART(14,15 還特意分出來了), SPI 都沒有佔用。 其餘的 GPIO 分為兩組並配備了電源接口,可以直接用作 GPIO,也可以控制外部設備:


  1. Servo0-Servo5:5v/25mA,小電流的 Servo 適合連接類似 LED 之類的設備。
  2. Dirver0-Driver4:5v/500mA,可以連接功率更大的設備 (例如 小車的馬達),+/- 極來自在板子左下角的外接電源。可以參考這個接法:https://www.raspberrypi.org/magpi/motor-aiy-voice-pi/

使用 Speech Recognition API & gTTS 套件


  • 用 Speech Recognition API 辨識中/英文

  • 用 gTTS 套件說中文


    gTTS: a Python library and CLI tool to interface with Google Translate's text-to-speech API,這是用 python 透過 google translate 轉換為語音的套件

  • 沒有智能語義 AI,不是 Google assistent


需要產生服務帳戶金鑰


由 Google Cloud Platform GCP 產生服務帳戶金鑰,並存放到 /home/pi/cloud_speech.json


測試程式 cloudspeech_demo.py


安裝 gTTS 相關套件


sudo python3 -m pip install gTTS
sudo python3 -m pip install pydub
sudo apt install ffmpeg

修改後的 cloudspeech_demo.py


#!/usr/bin/env python3
# Copyright 2017 Google Inc.
#
# Licensed under the Apache License, Version 2.0 (the "License");
# you may not use this file except in compliance with the License.
# You may obtain a copy of the License at
#
#     http://www.apache.org/licenses/LICENSE-2.0
#
# Unless required by applicable law or agreed to in writing, software
# distributed under the License is distributed on an "AS IS" BASIS,
# WITHOUT WARRANTIES OR CONDITIONS OF ANY KIND, either express or implied.
# See the License for the specific language governing permissions and
# limitations under the License.

"""A demo of the Google CloudSpeech recognizer."""
import argparse
import locale
import logging

from aiy.board import Board, Led
from aiy.cloudspeech import CloudSpeechClient
from aiy.voice import audio
from gtts import gTTS
from pydub import AudioSegment


def get_hints(language_code):
    if language_code.startswith('en_'):
        return ('turn on the light',
                'turn off the light',
                'blink the light',
                'goodbye')
    return None

def locale_language():
    language, _ = locale.getdefaultlocale()
    return language

def say(text, lang=None):
    if lang == None:
        tts = gTTS(text)
    else:
        tts = gTTS(text, lang)
     # 把文字變成gtts內建的物件
    tts.save('output.mp3') # 把得到的語音存成 output.mp3
    sound = AudioSegment.from_mp3('output.mp3') # 把 output.mp3 讀出
    sound.export('output.wav', format='wav') # 轉存成 output.wav
    audio.play_wav('output.wav') # 把 wav 用 VoiceKit 播出來

def main():
    # say('test')

    logging.basicConfig(level=logging.DEBUG)

    parser = argparse.ArgumentParser(description='Assistant service example.')
    parser.add_argument('--language', default=locale_language())
    args = parser.parse_args()

    logging.info('Initializing for language %s...', args.language)
    hints = get_hints(args.language)
    client = CloudSpeechClient()
    with Board() as board:
        while True:
            if hints:
                logging.info('Say something, e.g. %s.' % ', '.join(hints))
            else:
                logging.info('Say something.')
            text = client.recognize(language_code=args.language,
                                    hint_phrases=hints)
            if text is None:
                logging.info('You said nothing.')
                continue

            logging.info('You said: "%s"' % text)
            text = text.lower()
            if 'turn on the light' in text:
                board.led.state = Led.ON
                say('light is on')
            elif 'turn off the light' in text:
                board.led.state = Led.OFF
                say('light is off')
            elif 'blink the light' in text:
                board.led.state = Led.BLINK
                say('light is blinked')
            elif '開燈' in text:
                board.led.state = Led.ON
                say('燈開好了', 'zh-TW')
            elif '關燈' in text:
                board.led.state = Led.OFF
                say('燈關了', 'zh-TW')
            elif '閃燈' in text:
                board.led.state = Led.BLINK
                say('閃燈中', 'zh-TW')
            elif 'bye' in text:
                say('bye')
                break
            elif '結束' in text:
                say('再見', 'zh-TW')
                break
            elif 'goodbye' in text:
                say('bye')
                break

if __name__ == '__main__':
    main()

調整音量的指令


alsamixer

note:


pip3 install gTTS 出現 Error


Exception:
Traceback (most recent call last):
  File "/usr/share/python-wheels/urllib3-1.19.1-py2.py3-none-any.whl/urllib3/connectionpool.py", line 594, in urlopen
    chunked=chunked)
  File "/usr/share/python-wheels/urllib3-1.19.1-py2.py3-none-any.whl/urllib3/connectionpool.py", line 391, in _make_request
    six.raise_from(e, None)
  File "<string>", line 2, in raise_from
  File "/usr/share/python-wheels/urllib3-1.19.1-py2.py3-none-any.whl/urllib3/connectionpool.py", line 387, in _make_request
    httplib_response = conn.getresponse()
  File "/usr/lib/python3.5/http/client.py", line 1198, in getresponse
    response.begin()
  File "/usr/lib/python3.5/http/client.py", line 297, in begin
    version, status, reason = self._read_status()
  File "/usr/lib/python3.5/http/client.py", line 266, in _read_status
    raise RemoteDisconnected("Remote end closed connection without"
http.client.RemoteDisconnected: Remote end closed connection without response

During handling of the above exception, another exception occurred:

......
TypeError: unsupported operand type(s) for -=: 'Retry' and 'int'

解決方式:更新 requests


sudo python3 -m pip install --user --upgrade requests

解決方法:改用這個指令安裝


sudo python3 -m pip install gTTS

使用 Google Assistant Service API


需要產生 OAuth 用戶端 ID


note 設定過程中,會綁定到某一個帳號:


charley@maxkit.com.tw  google assistent auth code
4/qQGwcp38dePn7QQABHiXJwgS2Hhs6Jz6hG3sVX9l2Y6WIoUXgt5bFVo

存放到 /home/pi/assistant.json


程式使用內建 pico2wave 來合成語音,故不支援中文


demo 程式


  • ~/AIY-projects-python/src/examples/voice/assistantlibrarydemo.py


    ​ 要說 Hey Google 然後再問問題,只支援英文

  • ~/AIY-projects-python/src/examples/voice/assistantlibrarywithbuttondemo.py


    ​ 要說 Hey Google 或是按下按鈕,然後再問問題,只支援英文

  • assistantgrpcdemo.py


    ~/AIY-projects-python/src/examples/voice/
    
    ./assistant_grpc_demo.py

將 assitant demo 設定為開機自動啟動


ref: GOOGLE VOICE KIT AUTOSTART


sudo vim /etc/systemd/system/assistant.service


[Unit]
Description=Google Assistant
Wants=network-online.target
After=network-online.target
Wants=systemd-timesyncd.service
After=systemd-timesyncd.service

[Service]
Environment=DISPLAY=:0
Type=simple
ExecStart=/home/pi/AIY-projects-python/src/examples/voice/assistant_library_with_button_demo.py
Restart=on-failure
User=pi
Group=pi
StandardOutput=syslog
StandardError=syslog
SyslogIdentifier=google_assistant

[Install]
WantedBy=multi-user.target

sudo chmod 755 /etc/systemd/system/assistant.service

sudo systemctl daemon-reload
sudo systemctl enable assistant.service
sudo service assistant start

查閱 log


sudo journalctl -u assistant -f


客製化 hotword


ref: 語音喚醒技術的原理是什麼?


ref: 語音喚醒


語音喚醒在學術上被稱為keyword spotting(簡稱KWS),吳老師給它做了一個定義:在連續語流中實時檢測出說話人特定片段。


這裡要注意,檢測的「實時性」是一個關鍵點,語音喚醒的目的就是將設備從休眠狀態激活至運行狀態,所以喚醒詞說出之後,能立刻被檢測出來,用戶的體驗才會更好。


那麼,該怎樣評價語音喚醒的效果呢?通行的指標有四個方面,即喚醒率、誤喚醒、響應時間和功耗水平:


➤喚醒率,指用戶交互的成功率,專業術語為召回率,即recall。


➤誤喚醒,用戶未進行交互而設備被喚醒的概率,一般按天計算,如最多一天一次。


➤響應時間,指從用戶說完喚醒詞後,到設備給出反饋的時間差。


➤功耗水平,即喚醒系統的耗電情況。很多智能設備是通過電池供電,需要滿足長時續航,對功耗水平就比較在意。


喚醒可以看成是一種小資源的關鍵詞檢索任務,其中小資源是指計算資源比較小和空間存儲資源比較小,因此它的系統框架跟關鍵詞檢索的系統會有一定的區別,目前常用的系統框架主要有Keyword/Filler Hidden Markov Model System和Deep KWS System兩種。


陳果果 kitt.ai 開發 DNN based snowboy 提供不同 OS 的 library,可自訂 hotword,百度在 2017 全資收購。


custom-hotword-for-aiy-voicekit


# 安裝 libatlas-base-dev
sudo apt-get install libatlas-base-dev

cd ~/AIY-voice-kit-python

src/examples/voice/assistant_grpc_demo_snowboy.py --language en-US --model src/mod/resources/alexa/alexa_02092017.umdl
# hotword: alexa

只有 alexa 可以用,其他的自訂 hotword,都沒辦法偵測到


note: 安裝 VNC


ref: [基礎] 以 VNC 和 Raspberry Pi 連線


ref: 基礎篇 - vnc連線


sudo apt-get install tightvncserver

vncserver
# 設定密碼

在 vnc viewer 使用 192.168.1.175:5901 連線


Reference


AIY project github


Custom Hotword for AIY Voice Kit


lattepanda-使用google-assistant玩互動語音助理